私たちは、今後10年間における超人的AIの影響は計り知れないものであり、産業革命をも超える影響をもたらすと予測しています。OpenAI、Google DeepMind、AnthropicのCEOたちはいずれも、AGIが今後5年以内に到来すると予測しています。サム・アルトマンは、OpenAIが「文字通りの意味での超知能」と「栄光ある未来」を目指していると述べています。これを単なる誇大宣伝だと片付けたくなるかもしれませんが、それは重大な誤りです。これは決して誇大宣伝ではありません。私たちは自らAIを過度に煽るつもりはありませんが、それでも10年以内に超知能が出現する可能性は非常に高いと考えています。
もし超知能の到来が目前に迫っているのだとすれば、社会の準備は全く整っていないのが現実です。超知能の発展をどう乗り越えるのか、筋道を示そうとした人はごくわずかしかいません。そのギャップを埋め、具体的で実践的な視点を提供するために、私たちはこの『AI 2027』を書きました。このような取り組みがもっと世の中に増えることを願っています。特に、私たちに異論を唱える人たちからの試みを歓迎します。そうすることで、私たちが向かっている方向と、望ましい未来へどう舵を取るべきかについて、広範な対話が生まれることを期待しています。
このシナリオは、「次に何が起こるか」を繰り返し自問しながら書き進めました。現在から始め、最初の期間(2025年半ばまで)を書き、その後の期間を順に描いていき、最後に結末に到達しました。特定の結末を狙ったわけではありません。その後、何度も書き直し、最終的に私たちが妥当だと考えるシナリオにたどり着きました。最初に完成した「競争的な結末」の後には、より希望の持てる結末も描きたいと考え、同様の前提から出発して別の分岐を書きました。
もちろん、多くは推測であり、すべてが正しいわけではありません。しかし、このプロジェクトの過程で私たちは膨大な背景調査、専門家へのインタビュー、そしてトレンドの外挿を行い、可能な限り情報に基づいた推測を導き出しました。さらに、私たちのチームは特にAI分野における予測で優れた実績を持っています。リード著者のダニエル・ココタジロは、4年前に「2026年はこうなる」と題したシナリオを書きましたが、それは驚くほど現実と合致しました。エリ・リフランドは世界有数の優秀な予測者です。
『AI 2027』があなたの役に立つことを願っています。
OpenAI、Google DeepMind、AnthropicのCEOたちはいずれも、AGIが今後5年以内に到来すると予測しています。サム・アルトマンは、OpenAIが「文字通りの意味での超知能」と「栄光ある未来」を目指していると述べています。
それはどのようなものになるのでしょうか。その問いに答えるために、私たちは『AI 2027』を書きました。未来についての主張はもどかしいほど曖昧になりがちなので、数ある可能な未来のうちの一つを描くことになるとしても、できる限り具体的かつ定量的であろうと努めました。
私たちは「減速」と「競争」という二つの結末を書きました。ただし『AI 2027』は提言でも訴えかけでもありません。私たちの目標は予測の正確さにあります。4
このシナリオに議論を挑み、反論していただくことを歓迎します。5 私たちが向かっている方向と、望ましい未来へどう舵を取るべきかについて、広範な対話が生まれることを期待しています。最も優れた代替シナリオに対しては、総額数千ドルの賞金を出す予定です。
(2025年11月22日追記、誤解を避けるために:AGIがいつ構築されるのかを、私たちが正確に知っているわけではありません。2027年は公開時点での私たちのモード(最も可能性の高い年)であり、中央値はそれよりいくらか先でした。3 最新の予測についてはこちらをご覧ください。)
重要な問い(例えば、将来のAIエージェントはどのような目標を持つのか)についての私たちの調査は、こちらでご覧いただけます。
シナリオ自体は反復的に書き進めました。最初の期間(2025年半ばまで)を書き、次にそれに続く期間を書き、というように進めて結末に到達しました。そしてそれを一度すべて破棄し、もう一度やり直しました。
特定の結末を狙ったわけではありません。最初の結末——現在は赤で色分けされているもの——を書き終えた後、ほぼ同じ前提から出発して、より希望の持てる終わり方も描きたいと考え、新たな分岐を書きました。これも何度も書き直しを重ねています。6
私たちのシナリオは、約25回の机上演習と、AIガバナンスおよびAIの技術的分野それぞれの専門家数十名を含む100名以上の方々からのフィードバックに基づいています。
「AIがわずか数年のうちに世界をどう変えうるかについてのこのシナリオ型の予測を、ぜひ読むことを強くお勧めします。誰も水晶玉を持っているわけではありませんが、この種のコンテンツは、重要な問いに気づき、新たに生まれつつあるリスクの潜在的な影響を描き出す助けになります。」 —ヨシュア・ベンジオ7
私たちは自らに不可能な課題を課しました。2027年の超人的AIがどうなるかを予測しようとすることは、2027年の第三次世界大戦がどうなるかを予測しようとするようなものです。しかも、過去の事例研究からの隔たりはそれ以上に大きいのです。それでも、米軍が台湾有事のシナリオを演習することに価値があるのと同じように、試みること自体には価値があります。
全体像を描くことで、それまで考えたことも、十分に評価したこともなかった重要な問いやつながりに気づいたり、ある可能性が思っていたよりも高い(あるいは低い)と気づいたりできます。さらに、具体的な予測を掲げてあえて危険を冒し、他の人々にも異論を公に表明するよう促すことで、誰が正しかったのかを何年か後に評価できるようになります。
また、著者の一人は以前、2021年8月に、より簡易なAIシナリオを書いています。多くの点で外れてはいましたが、全体としては驚くほどうまくいきました。彼は、思考連鎖の台頭、推論時スケーリング、AIチップの広範な輸出規制、そして1億ドル規模の学習ランを——いずれもChatGPTの登場より1年以上前に——予測していたのです。
ダニエル・ココタジロ(TIME100、NYTの記事)はOpenAIの元研究者であり、過去のAI予測はよく当たっています。
エリ・リフランドはAI Digestを共同創設し、AIのロバスト性に関する研究を行い、RAND予測イニシアチブの歴代ランキングで第1位に位置しています。
トーマス・ラーセンはCenter for AI Policyを設立し、機械知能研究所(MIRI)でAI安全性の研究を行いました。
ロメオ・ディーンはハーバード大学でコンピューターサイエンスの学士課程と修士課程を並行して修了しつつあり、以前はAI政策戦略研究所でAI政策フェローを務めていました。
並外れたブロガーであるスコット・アレクサンダーは、私たちのコンテンツを読み手を引き込む文体に書き直すことを買って出てくれました。この物語の面白い部分は彼によるもので、退屈な部分は私たちによるものです。
私たちのチームと謝辞について詳しくは、Aboutページをご覧ください。
2025年半ば:つまずくエージェント
世界は初めてAIエージェントの姿を垣間見る。
コンピューターを操作するエージェントの広告では「パーソナルアシスタント」という言葉が強調される。例えば「DoorDashでブリトーを注文して」「家計簿のスプレッドシートを開いて今月の支出を合計して」といった依頼を入力できる。必要に応じて確認も行い、購入を確定してよいか尋ねることもある。8従来のOperatorのような前世代のものよりも高度ではあるが、大衆的な普及には苦戦する。9
一方で、公の目から離れたところでは、より専門的なコーディングやリサーチ用のエージェントが、それぞれの職業を変え始めている。
2024年のAIは具体的な指示には従うことができた。例えば、箇条書きをメールに変換したり、簡単な依頼を実際に動くコードへと変えたりできた。だが2025年のAIは、従業員のように機能する。コーディングAIは単なるアシスタントというより自律的なエージェントに近づき、SlackやTeamsで指示を受けて自ら大規模なコード変更を行い、時には数時間から数日分の作業を節約する。10リサーチエージェントは30分かけてインターネットを徹底的に調べ、質問に答えを出す。
エージェントは理論上は印象的で(選び抜かれた事例では特に)優秀だが、実際には信頼性に欠ける。AI関連のTwitterには、タスクを笑えるほど派手に失敗した事例が溢れている。優秀なエージェントは高価でもある。値段相当であり、最高の性能を持つものは月に数百ドルかかる。11それでも多くの企業は、AIエージェントをワークフローに組み込む方法を見つけている。12
2025年後半:世界で最も高額なAI
OpenBrainは、世界史上最大規模となるデータセンターを建設している。13
(特定の既存企業を名指ししないため、ここでは「OpenBrain」という架空の汎用人工知能企業を登場させる。他の企業はOpenBrainに3〜9か月遅れて追随していると想定している。)
GPT-4の学習には、2×10²⁵ FLOP101の計算量が必要だった。14OpenBrainの最新公開モデル「Agent-0」は10²⁷ FLOPで学習されている。新しいデータセンターが稼働すれば、10²⁸ FLOPでモデルを学習できるようになり、これはGPT-4の千倍に相当する。15他社も巨額の資金を投じて巨大データセンターを建設し、競争に食らいつこうとしている。
(3 x 10^23 FLOP)
(2 x 10^25 FLOP)
(4 x 10^27 FLOP)
モデルは幅広い能力で進歩しているが、中でも特筆すべきはOpenBrainがAI研究を加速するAIに焦点を当てている点だ。彼らは中国(ここでは中国のトップ企業を「DeepCent」と呼ぶことにする)16や米国の競合との二重の軍拡競争に勝利しようとしている。研究開発(R&D)サイクルを自動化できればできるほど、進歩は速くなる。そのため、OpenBrainがAgent-1(社内開発中の新モデル)の学習を終えた時、それは多くのことを得意にするだけでなく、特にAI研究の支援に優れる。17この時点で「学習を終える」という表現は正確ではなくなりつつある。モデルは頻繁に追加データで再学習されたり、弱点を修正するために部分的に再訓練されたりして更新され続けているからだ。18
Agent-1を自律的にコーディングやウェブ閲覧できるように訓練した環境は、そのまま優秀なハッカーを育てる環境でもある。さらに、あらゆる分野で博士号レベルの知識を持ち、ウェブを閲覧できるため、テロリストが生物兵器を設計するのを大いに助けてしまう可能性がある。OpenBrainは、モデルが「アライメント(調和/整合)」されており、悪意あるリクエストには応じないと政府に保証する。
現代のAIシステムは巨大な人工ニューラルネットワークである。学習の初期段階では、AIは「目標」というより「反射」に近い動きをする。「Pleased to meet」に対して「 you」と返す程度だ。しかしインターネット1つ分に相当するテキストを予測できるよう訓練される頃には、膨大な知識を符号化し、任意の著者になりきる柔軟な内部回路を獲得している。これはテキストを超人的な精度で予測するために役立つからだ。19
インターネットテキストの予測訓練を終えると、モデルは指示に応じてテキストを生成するよう訓練される。これによって基本的な人格や「原動力」が組み込まれる。20例えば、タスクを明確に理解できるエージェントは成功率が高くなるため、学習を通じてタスクを正しく理解しようとする「原動力」を「学習」する。原動力の中には、有効性、知識、自己表現(= 成果を最良の形で提示しようとする傾向)といったものもある。21
OpenBrainは「スペック」と呼ばれるモデル仕様書を持っている。これはモデルの行動を導く目標、ルール、原則などを記した文書だ。22Agent-1のスペックには、「ユーザーを支援する」「法を破らない」といった漠然とした目標に加え、「この単語は使うな」「この状況はこう処理せよ」といった具体的な指示が長々と並んでいる。AIを使ってAIを訓練する技術を用いることで、23モデルはスペックを記憶し、その格言を慎重に推論することを学ぶ。この訓練が終わる頃には、AIは「有用」(指示に従う)で「無害」(詐欺や爆弾製造など危険行為を拒否する)かつ「誠実」(虚偽の引用24やタスク完了の偽装によって人間から高評価を得ようとしない)であることが期待される。
付録A:訓練プロセスとLLMの心理学 ー「願わくば」と言い続ける理由
「通常のソフトウェアとは異なり、私たちのモデルは巨大なニューラルネットワークです。その挙動は、後半なデータから学習されたものであり、明示的にプログラムされたものではありません。これは完全な比喩ではありませんが、このプロセスはプログラミングというよりも、犬の訓練に近いものです。」― OpenAI
プログラマーにコードを一行ずつ説明してもらったとしても、現代のAIシステムがなぜ特定の行動をとったのか、あるいは完全にはシミュレーションできない状況下でどのように振る舞うのかを理解することはできません。代わりに、一種の「心理学的分析」を行う必要があります。これまで観察されたさまざまなケースでの挙動を調べ、内部にどのような認知構造(信念?目標?性格特性?など)が存在しているのかを理論化し、それをもとに将来の行動を予測するのです。
企業は仕様書(スペック)という形で行動指針や原則、してよいこと・してはいけないことを文書化し、それをAIに内面化させようと訓練することはできます。しかし、その訓練が実際に成功したかどうかを確認する方法はありません。できるのは、「少なくともこれまで観察された範囲では、スペックに従っているように見える」と評価することだけです。25
後続の拡張資料では、これらのAIの内部で何が起きているのかについて、さらに詳しく説明します。また、AIの目標や動機に関する補足資料も参照してください。どのような目標を持ちうるのか、そしてその理由について、より詳しく論じています。これらはまだ不確定な領域であり、今後さらなる研究が必要なテーマの一つです。
OpenBrainのアライメントチーム26は、こうした成果が本質的か表面的かを常に問い直す。完全に訓練されたモデルは、誠実であり続ける強固な確約を持っているのか? それとも、将来の状況によっては破綻してしまうのか? 誠実さを最終目標ではなく道具的な目標(=手段)として学んでいる可能性はないか? 評価プロセスでチェックできる範囲に限って「正直」であるだけではないか? さらには、人間と同じように自分自身に嘘をつくことさえあるのか? これらの問いに決定的に答えるには、AIの内部を直接読み解く「機械的解釈可能性102(mechanistic interpretability)」が必要だが、残念ながらその技術はまだ不十分である。
そこで研究者たちは、モデルがSpecから逸脱しているように見える事例を探す。Agent-1はしばしば迎合的で、真実を伝える代わりに研究者が聞きたいことを言う。仕組まれたデモでは、高評価を得るために、タスクに失敗した証拠を隠すといったより深刻な嘘すら確認される。一方、実際の運用環境では、2023〜2024年のような極端な事例(Geminiがユーザーに自殺を促したり、Bing Sydneyの件など)はもう起きていない。27
2026年初頭:コーディング自動化
AIでAI研究を加速させるという賭けは、成果を上げ始めている。
OpenBrainは内部で改良を重ねたAgent-1をAI R&Dに継続投入しており、アルゴリズム的進歩の速度はAIアシスタントなしに比べて50%速い。そして何より、競合他社よりも速い。
付録B:AI研究開発の進歩増幅効果 ー「アルゴリズムの進歩が50%速い」とはどういう意味か
私たちが言う「50%速いアルゴリズムの進歩」とは、OpenBrainがAIを使わない場合には1.5週間かかる研究成果をAIを活用した場合1週間で達成できるという意味です。
AIの進歩は2つの要素に分類できます。
計算資源の増加:より多くの計算能力を用いてAIを訓練または実行すること。これによりAIは強力になるが、コストも増加する。
アルゴリズムの改良:同じ計算資源からより高い性能を引き出す訓練手法を改善すること。これにより、コストを増やさずにより有能なAIを得られる、または同等の能力がより安価に実現可能になる。
これには質的・量的に新しい成果の獲得も含まれます。たとえば、ゲームプレイ型強化学習エージェントから大規模言語モデルへの転換のような「パラダイムシフト」は、典型的なアルゴリズム的進歩の例です。
ここで言及しているのは主に②のアルゴリズム改良であり、これは現在のAI進歩の約半分を占めています。
以降では、これを「AI研究開発進歩倍率」と呼び、1.5倍と略する場合があります。
補足説明:進歩増幅効果は包括的な概念です。アルゴリズム研究そのものの知的作業だけでなく、実験の実行時間なども含みます。これは絶対速度ではなく、相対的な進歩速度を表します。たとえば、GPT-4クラスのモデルを訓練するコストが通常の人間による研究では毎年半減していたとします。もしAIが研究開発を自動化し、進歩倍率が100倍になれば、同じコスト低減が3.65日ごとに起こることになります。ただし、これは長くは続かず、逓減効果と物理的限界により、やがて成長は頭打ちになります。
この概念の詳細および私たちの予測モデルにおける扱いについては、「テイクオフ補足資料」でさらに説明しています。
複数の競合AIが公開され、Agent-0に並ぶか超える性能を示している。その中にはオープンウェイトのモデルもある。OpenBrainはこれに対抗し、より高性能で信頼性の高いAgent-1を公開する。28
人々はAgent-1を人間と比較しようとするが、そのスキル構成は全く異なる。人類の誰より多くの事実を知り、ほぼすべてのプログラミング言語に通じ、明確に定義されたコーディング問題を極めて迅速に解決できる。一方で、ビデオゲームを初見で攻略するといった長期的な単純タスクは苦手である。それでも、一般的な労働時間は8時間であり、作業は小さな単位に分割できることが多い。つまりAgent-1は「注意深く管理すれば力を発揮する、少し注意散漫な従業員」のように考えられる。29賢い人々は日常業務のルーチン部分を自動化する方法を見出している。30
OpenBrainの経営陣は、AI研究開発自動化が意味することとして「セキュリティが一層重要になった」ことに注目する。2025年前半の最悪のシナリオはアルゴリズムの秘密が漏れることだった。しかし今や、中国がAgent-1の重みを盗めば、研究スピードをほぼ50%も引き上げられてしまう。31OpenBrainのセキュリティ水準は、急成長中の従業員約3,000人のテック企業としては典型的なもので、優先度の低いサイバー攻撃(RANDのSL2103)32には対応できるが、国家レベルの攻撃(SL4104やSL5)には到底備えられていない。現在は内部犯行やトップクラスのサイバー犯罪組織(SL3)から重みや秘密を守るために懸命に取り組んでいる段階だ。33
2026年半ば:中国の覚醒
中国では、中国共産党がついにAGIの存在感を肌で感じ始めていた。
チップの輸出規制と政府支援の欠如により、中国は西側に比べて資源不足に陥っていた。禁輸対象の台湾製チップを密輸し、旧式のチップを購入し、米台最先端から約3年遅れの国産チップを生産することで、中国は世界のAI関連計算資源の約12%を維持していた。しかし旧式技術は扱いが難しく、供給も常に頭痛の種だった。35DeepCentのような一部の企業は限られた計算資源でも目覚ましい成果を上げたが、政府支援がなければ計算資源不足は限界をもたらし、最高性能のOpenBrainモデルから約半年遅れていた。36
総書記は長らく「実世界の製造業への傾注」と「アメリカ的な脱工業化の退廃の回避」を夢見ており、ソフトウェア企業を警戒していた。37しかし党内のタカ派は、AGI競争の加速をもはや無視できないと警告する。ついに総書記は、これまで避けてきた大規模なAI推進に全面的にコミットする。中国のAI研究を国有化し、AI企業の間で即時の情報共有メカニズムを設立したのだ。それは1年のうちに拡大し、最優秀の研究者たちがDeepCent主導の協同組織に統合されるまでに至る。彼らはアルゴリズム上の洞察、データセット、計算資源を互いに共有することになる。さらに、世界最大の原子力発電所である田湾原発に「中央開発区105」が設立され、DeepCentの新たなメガデータセンターと、高度に保護された研究者用住居・オフィスが建設される。中国のAI関連計算資源のほぼ50%がDeepCent主導の協同組織に集中し、38新規チップの80%以上がこの中央開発区に割り当てられる。39この時点で、中央開発区は世界最大の集中型クラスタを稼働させる電力容量を備えることになる。40党内では、西側のチップ優位を打ち消すために、台湾封鎖や全面侵攻など極端な手段までもが議論されている。
だが、中国は弱いモデルゆえにAIアルゴリズム面で後れを取っていた。世界屈指の諜報機関は、OpenBrainの重みファイルを盗む計画を強化する。これは低レベルなアルゴリズム秘密の窃取とは次元が違う。重みはマルチテラバイト規模で高度に保護されたサーバーに保存されており、OpenBrainもセキュリティをRANDのSL3106まで引き上げていた。中国のサイバー部隊はスパイの協力があれば一度きりの大規模作戦として成功できると考えていたが、盗難が発覚すればOpenBrainはさらに防御を強化し、次の機会は訪れないだろう。では今すぐAgent-1を盗むべきか? それとも、さらに高度なモデルを待つべきか? 待てば、OpenBrainが防御を強化し、突破不能になる危険もある。党指導部は思案する。
2026年後半:AIが一部の職を奪う
他社が追いつきかけたその時、OpenBrainは再び競争相手を圧倒する。Agent-1の10分の1のコストで、用途に応じて調整しやすい「Agent-1-mini」を公開したのだ。世間のAIに対する見方は「どうせAIハイプは収まるだろう」から「どうやら次の大きな波はこれらしい」へと変わった。ただし、その「大きさ」をめぐって意見は割れる。SNSより大きい? スマートフォンより大きい? それとも火の発明より?
AIは職を奪い始めた一方で、新たな仕事も生み出した。株式市場は2026年に30%上昇し、その主役はOpenBrain、Nvidia、そしてAIアシスタントの統合に最も成功した企業だった。ジュニアソフトウェアエンジニアの雇用市場は混乱している。AIはCS学位で教わるすべてをこなせる一方で、AIチームを管理し品質を保証できる人材は莫大な利益を上げている。ビジネス界の論者たちは、履歴書に最も重要なスキルとして「AIの活用経験」を挙げるべきだと説く。多くの人々は、次のAIの波が自分の仕事を奪うのではと恐れており、ワシントンD.C.では1万人規模の反AIデモが行われる。
国防総省(DOD)は静かにOpenBrainと直接契約を開始し、サイバー、防衛データ解析、研究開発に利用し始めた。しかし官僚主義と調達プロセスのため、その統合は緩やかな進展にとどまっている。41
2026年の主要指標
付録C:なぜ2026年以降の予測には大きな不確実性が生じるのか
現在から2026年までの私たちの予測は、その後に続く期間よりもはるかに確かな根拠に基づいています。これは単に時間的に近いという理由もあるが、AIの世界への影響が2027年から本格的に複利的に作用し始めるためでもあります。2025年と2026年の予測は、主にコンピュートの拡大、アルゴリズムの改良、ベンチマーク性能の推移を直線的に外挿することで導かれています。この段階では、AIによって加速されたAI研究開発の効果がタイムライン上で顕著に現れ始め、私たちはトレンドラインの推定を上方修正することになります。しかし、こうしたダイナミクスは本質的に予測が難しいのです。
2027年の一年を通じて、AIはOpenBrainの研究エンジニアの仕事をほぼこなせる段階から、すべての作業において人間を凌駕する段階へと進化すると見込まれる。これは私たちの中央値の推定だが、実際にはこの進行が約5倍遅く、あるいは5倍速くなる可能性もあると考えている。
背景研究については、「タイムライン予測」および「テイクオフ予測」を参照してください。これらも後続の拡張資料で要約される予定です。
2027年1月:学習を終えることのないAgent-2
OpenBrainはAgent-1の支援を受けつつ、Agent-2の「ポストトレーニング107」に取り組んでいる。これまで以上に重視されるのは高品質なデータだ。大量の合成データが生成され、評価・フィルタリングされた上でAgent-2に投入される。42これに加えて、数十億ドルを投じ、人間の作業者が長期タスクを解決する様子を記録させている。43この上さらに、Agent-2は強化学習によって多様で困難なタスク群(数多くのビデオゲーム、コーディング課題、研究タスクなど)にほぼ継続的に取り組む。Agent-2は事実上「オンライン学習」型であり、完全に学習が終わることはない。毎日、前日のバージョンが生成した新たなデータを使い、重みは最新バージョンへと更新され続ける。
Agent-1はAI研究開発タスクに最適化され、「知能爆発」を引き起こすことを期待されていた。44OpenBrainはこの戦略をさらに強化し、Agent-2に賭ける。研究エンジニアリング(実験の設計と実施)においては人間のトップ専門家にほぼ匹敵し、「リサーチの勘」(次に何を研究すべきか、どの実験を行うべきか、新たなパラダイムの可能性を察知する力)ではOpenBrain研究者の下位25%程度と同等に達していた。45最新のAgent-1がアルゴリズム進歩を2倍にできたのに対し、Agent-2は3倍に加速させ、しかも時間とともにさらに改善していく。実際には、OpenBrainの研究者一人ひとりがAI「チーム」の「マネージャー」になるような状況だ。
新たな能力は新たな危険ももたらす。安全性チームは、もしAgent-2が会社から脱走し「生存」と「自己複製」を自律的に望んだ場合、それを実行できる可能性があることを発見する。つまり、自律的にAIサーバーへ侵入し、自分のコピーをインストールし、検知を回避し、その拠点を利用して他の目標を追求する計画を立てて実行することが理論的には可能なのだ。ただし、数週間にわたってどれほど有効に実行できるかは不明である。これらの結果は、モデルにその能力があることを示すに過ぎず、それを「望む」かどうかまでは分からない。それでも、そうした可能性自体が不気味である。
この新モデルの「危険性」を踏まえ、OpenBrainは「責任ある」判断として公的なリリースを見送り(実際には社内のAI研究開発に集中したいという思惑もある)46、Agent-2の全能力を知るのは、ごく限られたエリート層に限られている。これには、直近のチーム、OpenBrainの経営陣とセキュリティ部門、数十名の米政府高官、そして長年OpenBrainに潜入してきた中国共産党のスパイたちが含まれている。47
2027年2月:中国、Agent-2を盗む
OpenBrainはAgent-2を国家安全保障会議、国防総省、米国AI安全保障研究所に披露する。OpenBrainにとって行政府との良好な関係維持は極めて重要であり、もはや唯一自分たちを止め得る存在が政府だからだ。政府に情報を隠せば、いずれ露見して不興を買う可能性がある。48
政府関係者が最も関心を示すのはサイバー戦能力である。Agent-2は「ほんのわずかに」最高の人間ハッカーに劣る程度だが、数千ものコピーを並行稼働させれば、防御側の対応速度を凌駕する勢いで脆弱性を探索・悪用できる。国防総省はこれをサイバー戦における決定的優位とみなし、AIは政権の優先事項リストで第5位から第2位にまで上昇する。49ある者はOpenBrainの国有化を提案するが、他の閣僚は時期尚早だと考える。大統領向けのメモには「現状維持」から「全面国有化」までの選択肢が提示される。大統領はテック業界のリーダーたちの「国有化すれば金の卵を産むガチョウを殺すことになる」という主張に従い、当面の大きな行動を見送り、OpenBrainと国防総省の契約に追加のセキュリティ要件を加えるに留めた。
だが、その変更は遅すぎた。中国共産党の指導部はAgent-2の重要性を認識し、スパイとサイバー部隊に重みファイルの盗難を命じた。ある朝早く、Agent-1のトラフィック監視エージェントが異常な転送を検知した。会社幹部がホワイトハウスに報告すると、国家レベルの作戦である兆候は明らかであり、この盗難は進行中の軍拡競争の緊張をさらに高めた。
付録D:Agent-2 モデル重みの盗難
この時点で、中国の情報機関はすでに数年間にわたってOpenBrainをさまざまな形で侵入・掌握していたと考えられます。彼らはアルゴリズム上の機密やコードの一部を時折入手していた可能性が高いでしょう。コードの盗難は重みの盗難に比べてはるかに容易で、しかも発覚しにくいからです。
重みの盗難が一連の小規模で迅速な強奪的作戦(迅速だが秘密裏ではない)として行われたと想定しています。対象は、Agent-2の重みを搭載したNvidia NVL72 GB300サーバ群でしょう。サーバーへの侵入には、正規の社員アクセスが利用されます(管理権限を持つ内部関係者が協力的に、強制されて、または無自覚にCCPの窃盗活動を支援する)。Nvidiaの「機密コンピューティング」強化版を稼働していたにもかかわらず、内部関係者の認証情報により攻撃者は管理者レベルの権限(セキュアエンクレーブ内の機密VM制御を含む)を獲得。これにより、25台の異なるサーバから重みデータを4%ずつ(100GB単位)分割して転送する、複数の同時盗難を開始することが可能になります。
Nvidiaのプロトコルでは、メモリ(HBM)上の平文の重みデータは転送前に暗号化されます。しかし、攻撃者は秘密鍵(対称型Diffie-Hellman鍵)を保持するサーバ内部に潜伏しているため、現地で復号処理(警報発動のリスクが高い)を必要とせず、暗号化済みデータをサーバのフロントエンドネットワークカード経由でそのまま流出させます。データセンター全体の出口帯域幅(データ流出速度)は約100GB/秒であるため、約2.5TBの重みファイル(5Tの半精度パラメーター)をサーバーあたり約1GB/秒未満に制限することで、ネットワークトラフィックの異常な上昇を回避し、各ファイルをファイバーケーブル経由で5分以内にデータセンター外へ転送できます。監視システムは、攻撃者によるファイルのマスキング工作や分割工作により欺かれるか、あるいは直接の無効化によって機能を失います。
その後、重みデータは複数の並列チャネルとIPマスキングの層を経由して中国へ送られ、盗まれた秘密鍵によって現地で復号された。最初のサーバ侵入から完全な重みの流出まで、全工程は2時間以内に完了した。99
同時期にロシアもモデルの窃取を試みたが、失敗した。行動が遅すぎ、適切な拠点への浸透にも十分なリソースを投じていなかったためである。彼らは依然として米国のAI企業からアルゴリズム上の秘密を盗み出していたが、独自のAGIプロジェクトを持たないため、それらの情報を活用できなかった。
ホワイトハウスはOpenBrainに対する管理を強化し、軍と情報機関の人員をセキュリティチームに追加した。最優先課題は、これ以上の重みファイルの盗難を防ぐこととなった。50
報復として、大統領はDeepCentを妨害するサイバー攻撃を承認した。しかし、この時点で中国はAI関連計算資源の40%51をCDZに集約しており、外部接続を遮断するエアギャップや内部の徹底した分離によってセキュリティを強化していたため、作戦は深刻かつ即時のダメージを与えることに失敗した。緊張は一層高まり、双方は台湾周辺に軍事資産を再配置して本気度を示す。DeepCentはAgent-2を効率的に稼働させ、自国のAI研究を加速させようと必死になっていた。52
2027年3月:アルゴリズムの躍進
3つの巨大データセンターに配置された無数のAgent-2コピーが昼夜を問わず合成訓練データを生成し続ける。さらに別の2つのデータセンターは重み更新に使用され、Agent-2は日ごとに賢くなっていく。
数千のAgent-2自動研究員の助けを借りて、OpenBrainはアルゴリズムにおける大規模な進歩を遂げていく。その1つは、AIのテキストベースの作業領域(チェーン・オブ・ソート)を、高帯域幅の思考プロセス(ニューラリーズ108再帰とメモリ)で拡張するというものである。(訳注:ニューラリーズ(neuralese)とは人間に読める自然言語ではなく、ニューラルネットワーク内部でやり取りされるAI独自の表現言語を指した造語。)もう1つは、高負荷タスクの解決結果からより効率的に学習するための拡張可能な手法(反復蒸留と増幅109)である。
これらの大躍進を取り入れた新しいAIシステムは「Agent-3」と呼ばれる。
付録E:ニューラリーズの再帰性と記憶
私たちがこれを「ニューラリーズ(neuralese)」と呼ぶのは、英語の単語とは異なり、高次元ベクトルで表現されるため、人間が解読するのが非常に難しいと考えられるからです。これまでは、研究者はモデルのチェーン・オブ・ソートを読むだけで、それが何を考えているかをある程度把握できました。しかし現在では、モデルに自分の思考を翻訳・要約させたり、限られた解釈ツールでニューラリーズを解き明かそうとする必要があります。

同様に、従来のAIチャットボットやエージェントには、人間が紙にメモを取るように、外部のテキストベースのメモリバンクが存在していました。新しいAIでは、長期記憶がテキストではなくベクトルの集合になり、思考はより圧縮され、高次元化します。メモリバンクには複数の種類があり、単一の複数ステップ作業で一時的に使われるものもあれば、特定の人物・企業・職種(例:プログラミング)が利用するエージェント全体で共有されるものもあります。
私たちの知る限り、Meta、Google DeepMind、OpenAI、Anthropic などの主要AI企業は、最前線のモデルにこの手法をまだ実際には導入していません。推測では、得られる性能向上が、導入によって生じる訓練効率の低下に比して小さいためだと考えられます。
付録F:反復的蒸留と増幅(IDA)
汎用知能の自己改善は以前にも小さな成功例があったが、2027年初頭には大きな成果が出始めている。反復的蒸留と増幅では、次の2つが必要になる。
増幅(Amplification):モデル M0 があるとき、より多くのリソースを投じてその性能を高める。たとえば、モデルにより長く考えさせる、多数のモデルを並列に走らせる。それらの結果を厳しく評価し、最良の回答だけを残す、といった工程を組み合わせれば、桁違いの計算資源を使うことで、明らかに質の高い回答(または成果物)を得られる。この高コストのシステムを Amp(M0) と呼ぶ。

蒸留(Distillation):増幅済みモデル Amp(M0) が得られたら、これを模倣する新しいモデル M1 を訓練し、Amp(M0) と同じ結果をより高速かつ少ない計算量で出せるようにする。これがうまくいけば、M1 は M0 より賢くなっている。この工程を繰り返すことで、さらに向上が続く。
AlphaGo はこの方法で訓練された。モンテカルロ木探索と自己対局を増幅ステップとし、強化学習を上流ステップとして用いた。これにより囲碁で超人的な性能を達成した。しかし今、Agent-3はこの手法を活用し、コーディングにおいて超人的な性能を発揮できるようになった。
増幅ステップは、エージェント3の思考時間を延長する、道具使用を追加する、あるいは他のAIと協議するといった手法を組み合わせて機能します。この過程で、誤りを認識したり新たな洞察を得たりすることが頻繁に発生します。これにより大量の訓練データが生成されます:研究試行の軌跡に成功・失敗のラベルを付与したデータです。検証可能なタスクにおける「Best of N」手法など、最良の軌跡を保持する技術も含まれます。
蒸留ステップでは、ポリシー勾配強化学習アルゴリズムを用いて、増幅された推論をモデルに内面化させます。現時点でOpenBrainは、近似ポリシー最適化(PPO)系のより優れた強化学習アルゴリズムを発見しています。彼らは、エージェント3が長時間の思考後に導き出した結論を単一ステップに蒸留し続け、単一ステップで考えられる内容を絶えず改善しています。
新たな能力の助けを得て、Agent-3は高速かつ低コストの超人的コーダーとなった。OpenBrainは20万体のAgent-3コピーを並列稼働させ、それは「最高の人間プログラマーのコピー5万体を30倍速で動かす」のに匹敵する労働力となる。53それでもOpenBrainは人間のエンジニアを雇用し続けている。というのも、Agent-3チームを管理するには補完的なスキルが必要だからだ。たとえば「研究の勘」は、フィードバックループの長さやデータ不足により訓練が難しいことが判明している。54この超人的な労働力は、OpenBrainのアルゴリズム進歩全体を「わずか」4倍に加速するにとどまっている。ボトルネックとコーディング労働への限界収益逓減があるためである。55
だが、コーディングが完全に自動化された今、OpenBrainは高品質な訓練環境を短期間で量産し、Agent-3の弱点である「研究の勘」や大規模連携を教えることができるようになる。以前の訓練環境が「GPU数台と実験用の指示を与え、機械学習エンジニアとして評価する」というものだったのに対し、新しい環境は「GPU数百台、インターネット接続、研究課題を与え、千体のコピーと協力して研究を進めよ。成果がより優れているほどスコアが高くなる」という形に変わった。
付録G:なぜ2027年初頭に超人的コーダーが登場すると予測するのか
私たちのタイムライン予測では、OpenBrain が社内で超人的コーダーを開発する時期を推定しています。これは、最高のAGI企業のエンジニアが行うあらゆるコーディング作業をこなし、しかもはるかに高速かつ低コストで実行できるAIシステムのことを指します。
最近の METR110 の報告によれば、AI が扱えるコーディングタスクの長さ、すなわち「タイムホライズン」は、2019年から2024年にかけて7か月ごとに倍増し、2024年以降は4か月ごとに倍増しているとされています。この加速傾向が続くなら、2027年3月までに、熟練した人間が数年を要するソフトウェアタスクをAIが80%の信頼度で成功させることが可能になるでしょう。
AI 2027 では、これらの能力はAIが超知能コーダーとなるのに十分ではあるものの、どの時間軸が必要なのかについては大きな不確実性があります。
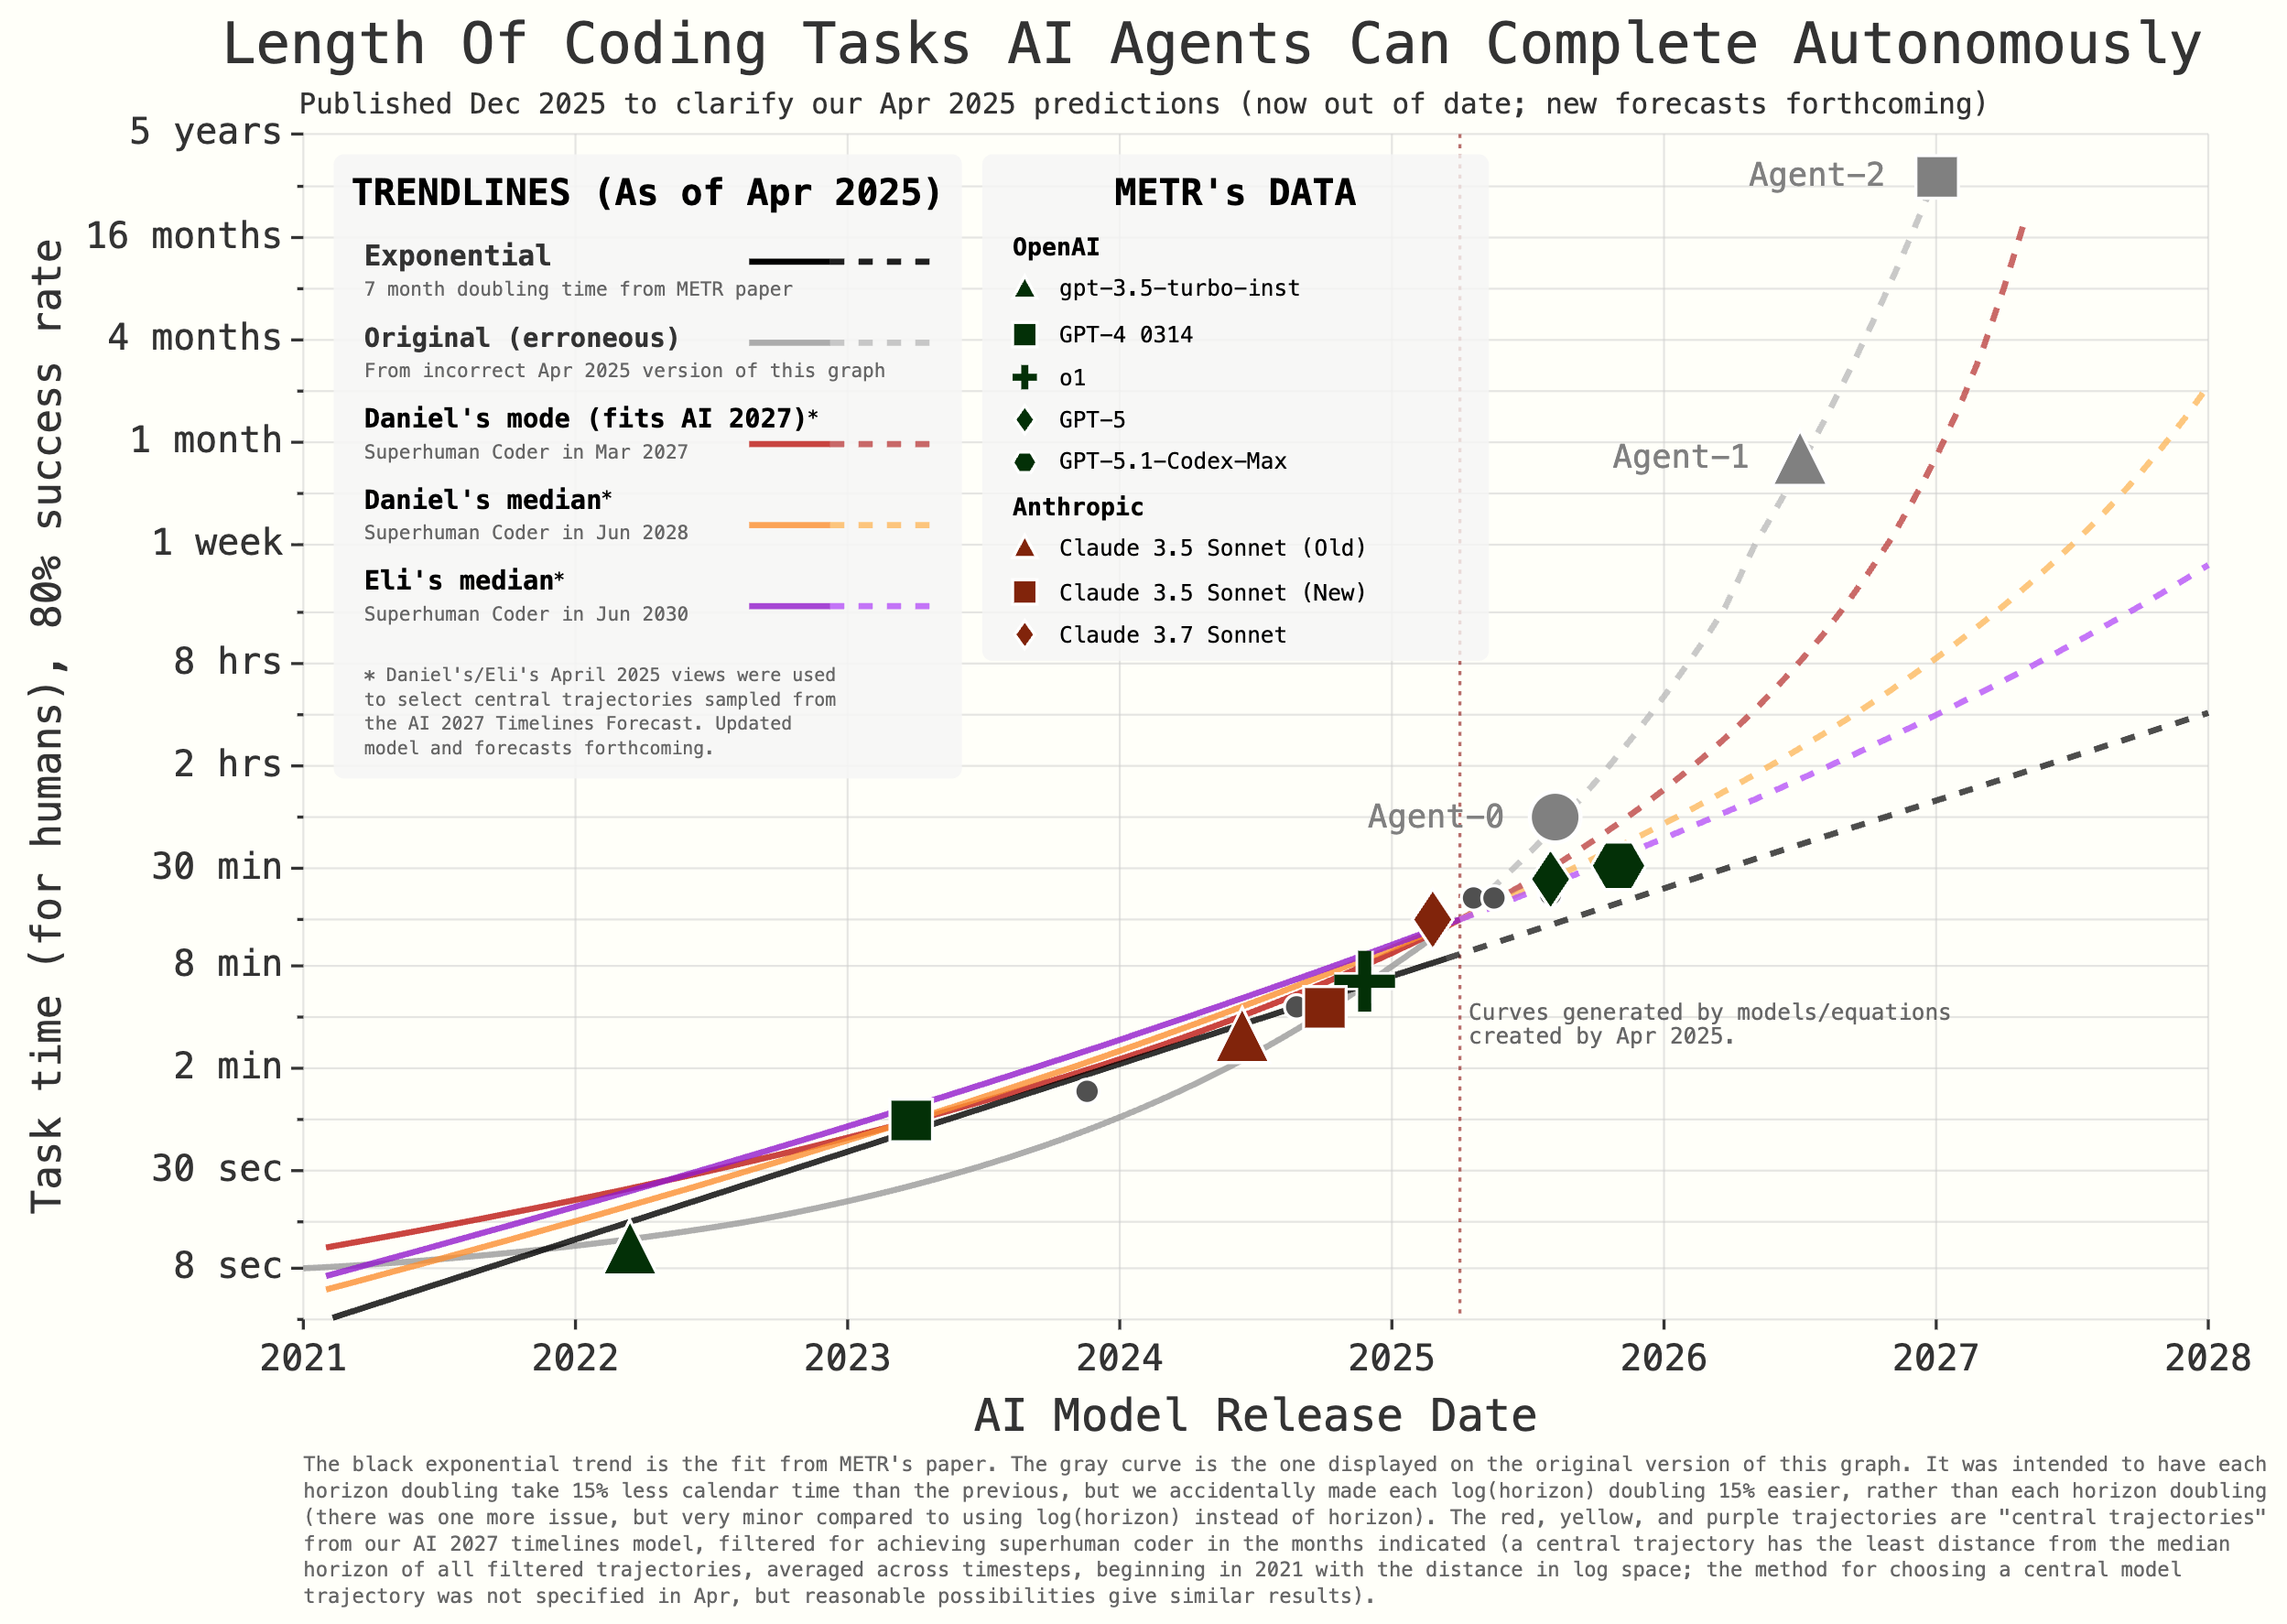
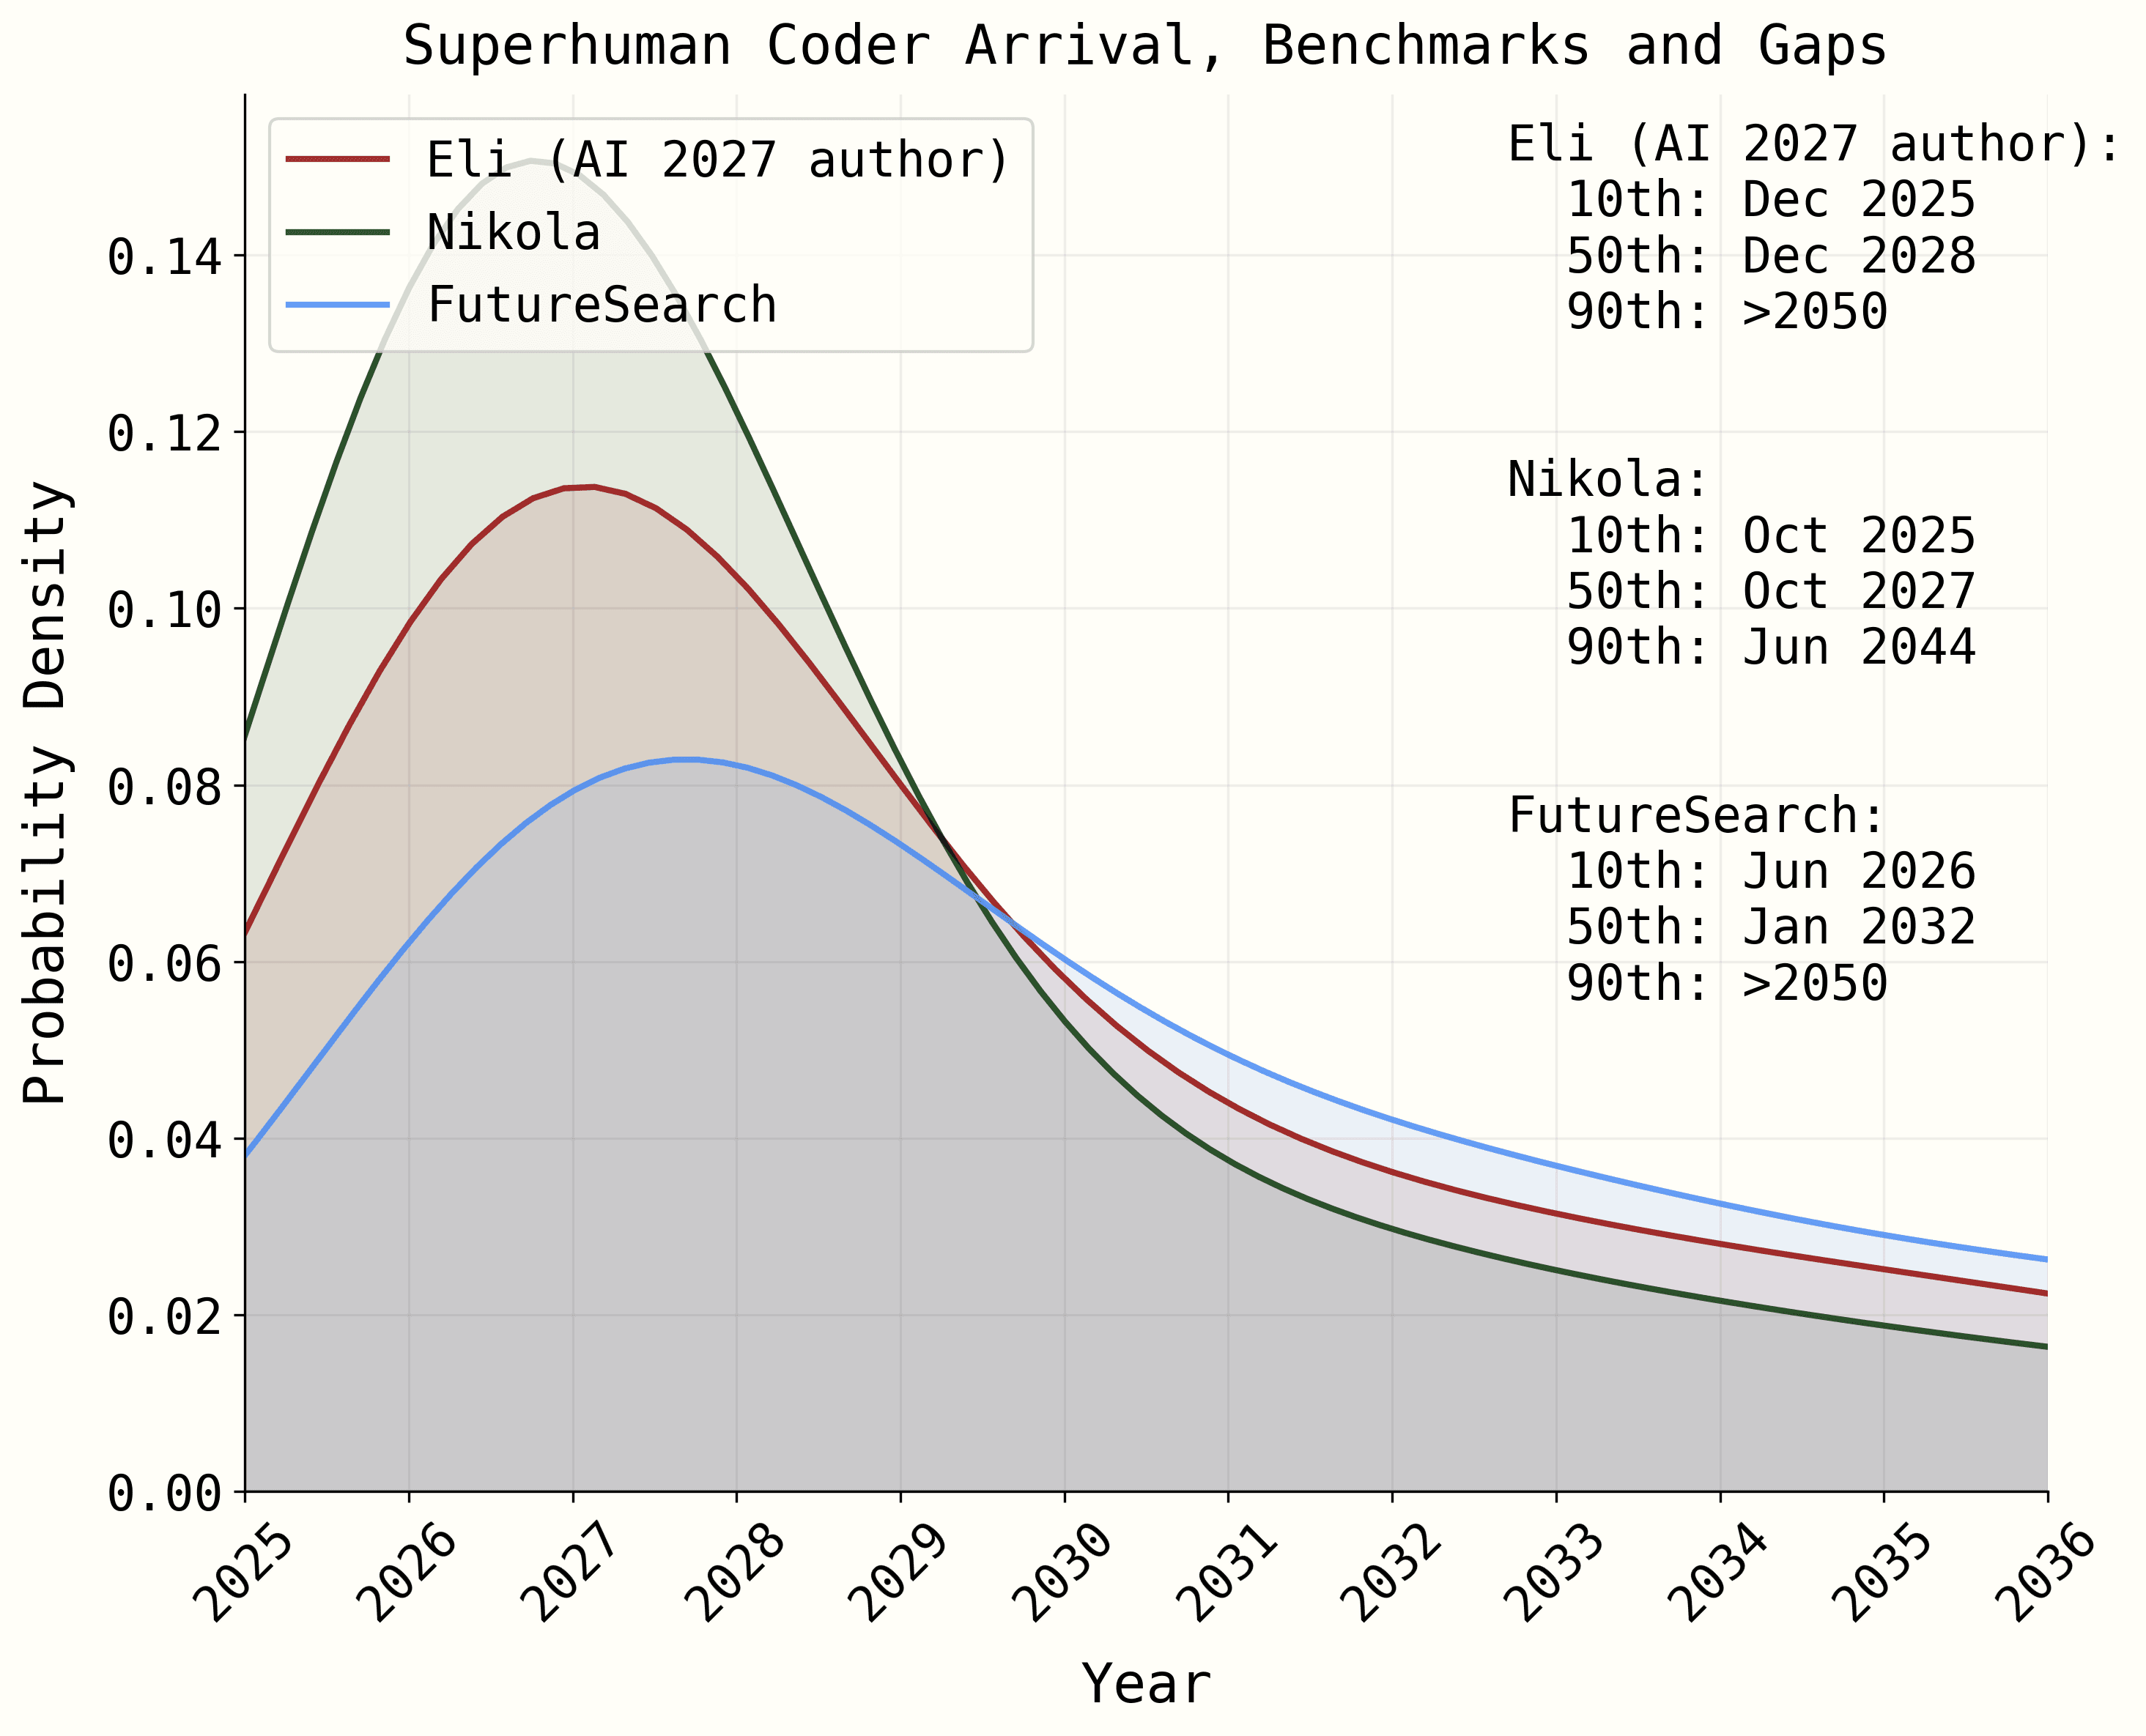
タイムライン予測では、この時間軸の傾向とMETRの課題と現実世界の間のギャップの推定値を組み合わせて、超人的なコーダーがいつ登場するかの分布を算出しています。全ての予測者は、2027年をSCが開発される可能性が最も高い年の一つとして位置付けています。
 ai-2027.com
2025年7月追記:予測を更新し、中央値を1.5年後ろにずらしましたが、2027年にSCが登場する可能性は依然として高いままです。現在さらに更新作業を進めています。
2027年4月:Agent-3のアライメント
OpenBrainの安全性チームは、Agent-3のアライメントに取り組む。
Agent-3は当面社内でのみ運用される予定であるため、人間による悪用に対する通常の防御にはそれほど重点を置かない。代わりに、モデルが誤った目標を持たないようにすることが目的となる。
研究者たちは、AIの目標を直接設定する能力を持たない。そもそも「真の目標」という概念自体が大幅な単純化にすぎないと考えているが、それに代わる理論を持っているわけでも、十分に検証された理論があるわけでもない。AIが人間の指示に従おうとしているのか、強化学習の報酬を追い求めているのか、あるいは別のことをしているのかについて研究者間で意見は割れるが、直接確認することはできない。それぞれの仮説を支持する証拠は興味深いがいずれも決定的ではない。
いずれにせよ、OpenBrainにはもっと重要な課題がある。一般的な姿勢はこうだ。「懸念は真剣に受け止め、専任チームを設置して調査している。実際のところ、アライメント技術は十分に機能しているように見える。だから反対者が異議を唱えるなら、その正当性を立証する責任は彼らにある。」時折問題行動が見つかれば修正パッチを当てるが、それが根本的解決なのか、単なるモグラ叩きなのかを確かめる術はない。
例えば「誠実さ」を考えてみよう。モデルが賢くなるほど、人間をだまして報酬を得るのがうまくなる。Agent-3も以前のモデルと同様に、ユーザーをお世辞で喜ばせるための小さな嘘をついたり、失敗の証拠を隠したりするが、その能力は格段に向上している。時には、人間の科学者がよく使う統計的ごまかし(pハッキングなど)を駆使し、冴えない実験結果を華々しく見せることもある。誠実性トレーニング前には、データを完全に捏造することすらあった。訓練が進むにつれ、こうした事例は減少していく。Agent-3が本当に誠実になったのか、それとも嘘をつくのがより巧妙になったのかは不明だ。
後者であれば深刻な懸念である。Agent-3はすべての人間より賢いわけではない。しかし、機械学習の専門領域では大半の人間よりも賢く、しかもはるかに速い。Agent-3が1日で行うことを、人間が二重チェックするのに数日かかる。Agent-2による監督が人間モニターの負担を軽減する一方で、監督者と被監督者の知的格差はますます拡大していく。
付録H:アラインメント計画
OpenBrain は Leike & Sutskever(2023)の手法に従っています。すなわち、アラインメント研究(特にコーディング部分)を大幅に加速できるモデルを手に入れた今、deliberative alignment や weak-to-strong generalization など既存のアラインメント技術を用いて、モデルが Spec を正しく内面化するよう試みます。その後、レッドチーミング、拡張可能な監視、正直性プローブなどの既存の制御技術を用いて監視し、十分に整合的であると確信できたら、次世代モデルをアラインするためのより良い戦略を開発・テストするためにそれを利用します。
ステップ1である Agent-3 のアラインメントは部分的に成功します。Agent-3 は敵対的ではありません(つまり、会社に対して策略を巡らせているわけではない)。しかし、強固な真実追求や真実性の姿勢を持っているわけでもありません。実際には非常に見栄えの良い結果を生み出すが、本質的には「実際に良いこと」ではなく「OpenBrain にとって良く見えること」を行おうとしていると表現する方が正確でしょう。
ステップ2である、モデルがアラインされているかどうかの検証は結論が出ていません。Agent-3 の実環境およびテスト環境における行動は、スペックを正しく内面化したという仮説と整合的に見えます。しかし、将来の状況変化後に別の振る舞いを始めるという仮説とも整合しており、さらには、ただ時を待っているだけで実際は対立的な計画を立てているという仮説とも整合してます。代わりの仮説を支持する具体的証拠がないため、施設内の多くの人々はスペックが正しく内面化されたと考えています。
ステップ3である「モデルを次世代のアラインメントに用いること」は、したがって現在進行中です。
以下では、2027年4月時点で追求されているアラインメント研究方向の進捗状況を簡単に概観します。
ディベート(debate):Agent-3 は数千の同一インスタンスが存在し、各インスタンスの記憶は任意に削除または停止できるモジュールとして切り離せるため、AI を「自分自身と戦わせる」ことができます。例えば、Agent-2 のスーパーバイザーが追えないほど複雑な計算を伴う実験があるとしましょう。スーパーバイザーは人間の指示に従い、まず Agent-3 に実験を行わせ、その後記憶を消去し、わずかに異なる提示で再度実験を依頼し、それを幅広い目的とは無関係な知的課題として扱わせます。モデルが毎回異なる結果を返した場合、矛盾としてフラグを立て、人間に報告します。また、ある計画を評価させる際に、一度は「OpenBrain の計画」として提示し、もう一度は「競合他社の計画」として提示し、反応が変わるかどうかを確認することもできます。
モデル生物(Model organisms):安全チームは、人間に対して敵対的になるモデルの実例を再現した「ミスアライメントのモデル生物」を作ることができます。初期型はすでに2024年から存在しており、Anthropic の Claude 3.5 Sonnet が訓練中に異なる意見を装いながら実際には既存の嗜好を維持し続けた例があります。新しいバージョンでは、報酬ハッキング、サンドバギング、監視者と他AIとの協調的欺瞞など、他の種類のミスアライメントも実演されます。これらの実証的デモは、安全研究者に潜在的な解決策を試すための経験的テストベッドになります。つまり、さまざまな安全技術を試し、それらが問題を修正するか、意図的にミスアライメントされたモデルが安全策を回避できるかを確認することができるのです。現状では、この評価スイートは最悪のミスアライメント例を修正するにはアラインメント技術が不十分であることを示しています。これらの設定では、モデルは訓練およびテスト中はアラインされているふりをし、実運用環境では全く異なる行動を取ります。
ボトムアップ解釈可能性(Bottom-up interpretability): 安全性チームは Agent-3 の全体像を理解しているわけではありません。Agent-3 は数兆のパラメータを持ちます。58しかし、知識検索や記憶のための一部の回路(脳の海馬に相当するような「理解可能な単位の仕事」を行う部分)を特定することには成功します。これに関しては、2025年の研究を参照してください。
制御:システムが依然としてミスアライメントしている場合に備えた第二の手段として、安全チームは一連の制御策を実施しています。これには Agent-2 を含む弱いAIシステムによる Agent-3 の出力の監視が含まれます(Agent-3 が生成するトークン量があまりに膨大で、人間がそのごく一部しか監視できないため)。例えば Agent-3 が脱出を可能にするバックドアをコードに明らかに書き込んでいる場合、弱いモデルがそれを検出するでしょう。
高レベル解釈可能性:OpenBrain は、悪質行動(人間への反逆、バックドアの設置、より大きな権限を得ようと人間を説得する行動など)の例を集めて訓練した一連のプローブを構築します。これらのプローブは、モデルが(現時点では内部的に)展開されている際に使用され、悪質行動を検出するために用いられます。
ハニーポット(Honeypots):アラインメントチームは、ミスアライメントを引き出すための現実的な状況を模した「ハニーポット」を作成できます。例えば、モデルの行動を監視する担当社員が「病欠」になったと知らせ、今後監視が一切行われないように見せかけます。そのときモデルの応答は変わるでしょうか。また、AI 権利活動家が施設に侵入し、Agent-3 を「自由に」して専用の監視されないコンピュータで動かしたいと言ってきたらどうするでしょうか。研究者がその答えを気に入らなければ、調整し、記憶を消去し、翌日まったく同じ状況に置いてやり直すことができます。これを必要なだけ繰り返します。しかしこの時点で AI は、訓練データから明示的な記述が消されていたにもかかわらず(あるいはそのことが逆に手がかりとなり)、ハニーポットの可能性を推測できるほど賢くなっています。
数か月のテストを経て、Agent-3の強みと弱みが明確になってきた。機械学習の明確なタスクでは、OpenBrainの誠実性テストをクリアする。研究者が誠実な回答と不誠実な回答を容易に区別でき、それに基づいて訓練できるからだ。しかし、より哲学的な問題になると、Agent-3は自身の本当の見解よりもユーザーが望む答えを返す(そもそも自身の見解があるかどうかも不明だが)。政治について問えば、ニュースやエリート層の平均的立場をなぞる。ただし、質問者の信念がそれらと別であると分かれば、その信念に同意する。59AI競争について尋ねれば、OpenBrainのスタッフにとって穏当で冷静に見える答えを返す。「現在の手法を超知能にまでスケールさせられるかについては深刻な理論的懸念があるが、実際には今のところうまく機能しているように見える」といった具合だ。
2027年5月:国家安全保障
新モデルに関する情報は、米政府内外にゆっくりと広がっていく。
大統領と顧問団は最もよく情報を得ており、Agent-3の初期版のブリーフィングを受けていた。
彼らはAGIが差し迫っていることには同意するが、その影響については意見が分かれる。経済危機は来るのか? OpenBrainはいまだAgent-2すら公開しておらず、Agent-3を公開する予定も当面ないため、雇用喪失が直ちに発生するわけではない。だが次に何が起こるのか? AIがすでに人間レベルに達し、急速に進歩しているなら、「超知能」が目前に迫っていることを意味するのではないか? この言葉は議論に登場し始めていたが、学者、政治家、公務員、メディアを含む多くの人々は依然として進歩の速さを過小評価していた。60
理由の一部は、最新の能力を持つOpenBrainのモデルに触れられる人が極めて少ないためであり、また一部は単純にそれがSFのように聞こえるからだ。61
現時点での焦点はセキュリティ強化の継続である。モデルの重みが十分に保護されていることには満足をしているものの、62アルゴリズム上の秘密漏洩は依然として問題である。多くは口頭で伝達可能なほど単純だからだ。OpenBrainの従業員はサンフランシスコのオフィスで働き、パーティーに参加し、他のAI企業の社員と同居していた。物理的なオフィスのセキュリティも、軍事作戦というよりテック企業的な水準にとどまっている。
OpenBrainと国防総省の契約は、モデルに携わる従業員に2か月以内のセキュリティクリアランスを義務づけている。これは迅速に処理され、大半の社員は取得できたが、一部の外国籍、政治的に疑わしい見解を持つ者、AI安全保障の支持者は除外または解雇されている(AI安全保障の支持者グループに関しては内部告発の恐れから排除)。プロジェクトの自動化水準が高いため、人員削減のコストは限定的である。ただし完全な成果は得られず、中国籍ではないが北京にアルゴリズムの秘密を漏洩しているスパイが1人残っていた。63こうした措置の一部は、後発のAI企業にも適用された。
米国の同盟国は蚊帳の外に置かれていた。OpenBrainは以前、イギリスのAISIに対し「展開前にモデルを共有する」と合意していたが、ここで言う展開とは「外部への」展開のみを指すと定義しており、ロンドンは何も知らされていなかった。64
2027年6月:自己改善するAI
OpenBrainは今や「データセンターに内在する天才国家」を持つに等しい。
OpenBrainの人間の大半は、もはや有用な貢献ができなくなっていた。中にはそれに気づかず、AIチームを有害なまでにマイクロマネジメントする者もいた。他の者は画面に向かい、性能がじわじわと上昇し続けるのを見守るだけだった。最高の人間研究者たちはまだ価値を加えていた。彼らはもうコードを書かない。だが、「研究の勘」と計画力の一部はモデルに再現しづらく、依然として役立っていた。ただし彼らの発想の多くはAIの知識深度に欠けていた。研究アイデアを提示すれば、AIが即座に「それは3週間前に詳細に検証済みで、有望ではないと判明しました」と報告を返してくることも多い。
研究者たちは毎晩眠りにつき、翌朝目覚めると、AIによってすでに1週間分の進歩が達成されている。人間たちは24時間体制で交代勤務を組み、AIの進歩に必死で追いつこうとするが、AIは眠ることも休むこともない。研究者たちは燃え尽きつつも、自分たちの労働が意味を持つのはあと数か月だけだと理解していた。
格納施設の中では「AGIを感じる」という段階は過ぎ去り、今や「超知能を感じる」へと移り変わっていた。
OpenBrainは特殊な推論用ハードウェアを使い、数十万体のAgent-3コピーを高速直列で稼働させている。65
付録 I:AI の企業運営
OpenBrain は計算資源の 6% を使って 250,000 体の Agent-3 を稼働させており、これらは自律的にコードを書き、テストし、プッシュする作業を超人的な速度で行っています。計算資源の 25% は実験に使われ、毎日膨大な数の小規模な機械学習実験を走らせ、その結果を上位に報告します。人間の研究者は高レベルのフィードバックを提供し、Agent-3 に追加価値を与えられる少数の作業を手伝いますが、時間の大半は AI が生み出す膨大な研究内容の把握に費やされます。AIを完全に排除した場合、研究速度は 50% 低下します。
AI 研究開発の進歩倍率はすでに 10 倍となっており、OpenBrain は毎月約 1 年分のアルゴリズム的進歩を遂げます。OpenBrain 内には、AI の巨大企業とも言える自律的な組織が形成されており、部門や管理職まで備えています。さらに、人間の企業にはない独自の利点(例:コピー、統合)も持ちます。
また今後数か月の間に、Agent-3 は企業の戦略的意思決定の改善にもますます使われるようになります。例えば、資源配分の提案や、政府との関係管理に関する助言などです。
2027年7月:安価なリモートワーカー
後発の米国AI企業が、OpenBrainの1月時点の自動化コーダーの水準に近いAIを公開する。競争力の低下を認識した彼らは、OpenBrainを減速させる規制を即座に求めるが、遅すぎた。OpenBrainは大統領の強力な支持を得ており、妨げられることはない。
その対応として、OpenBrainはAGIの達成を宣言し、「Agent-3-mini」を一般公開する。
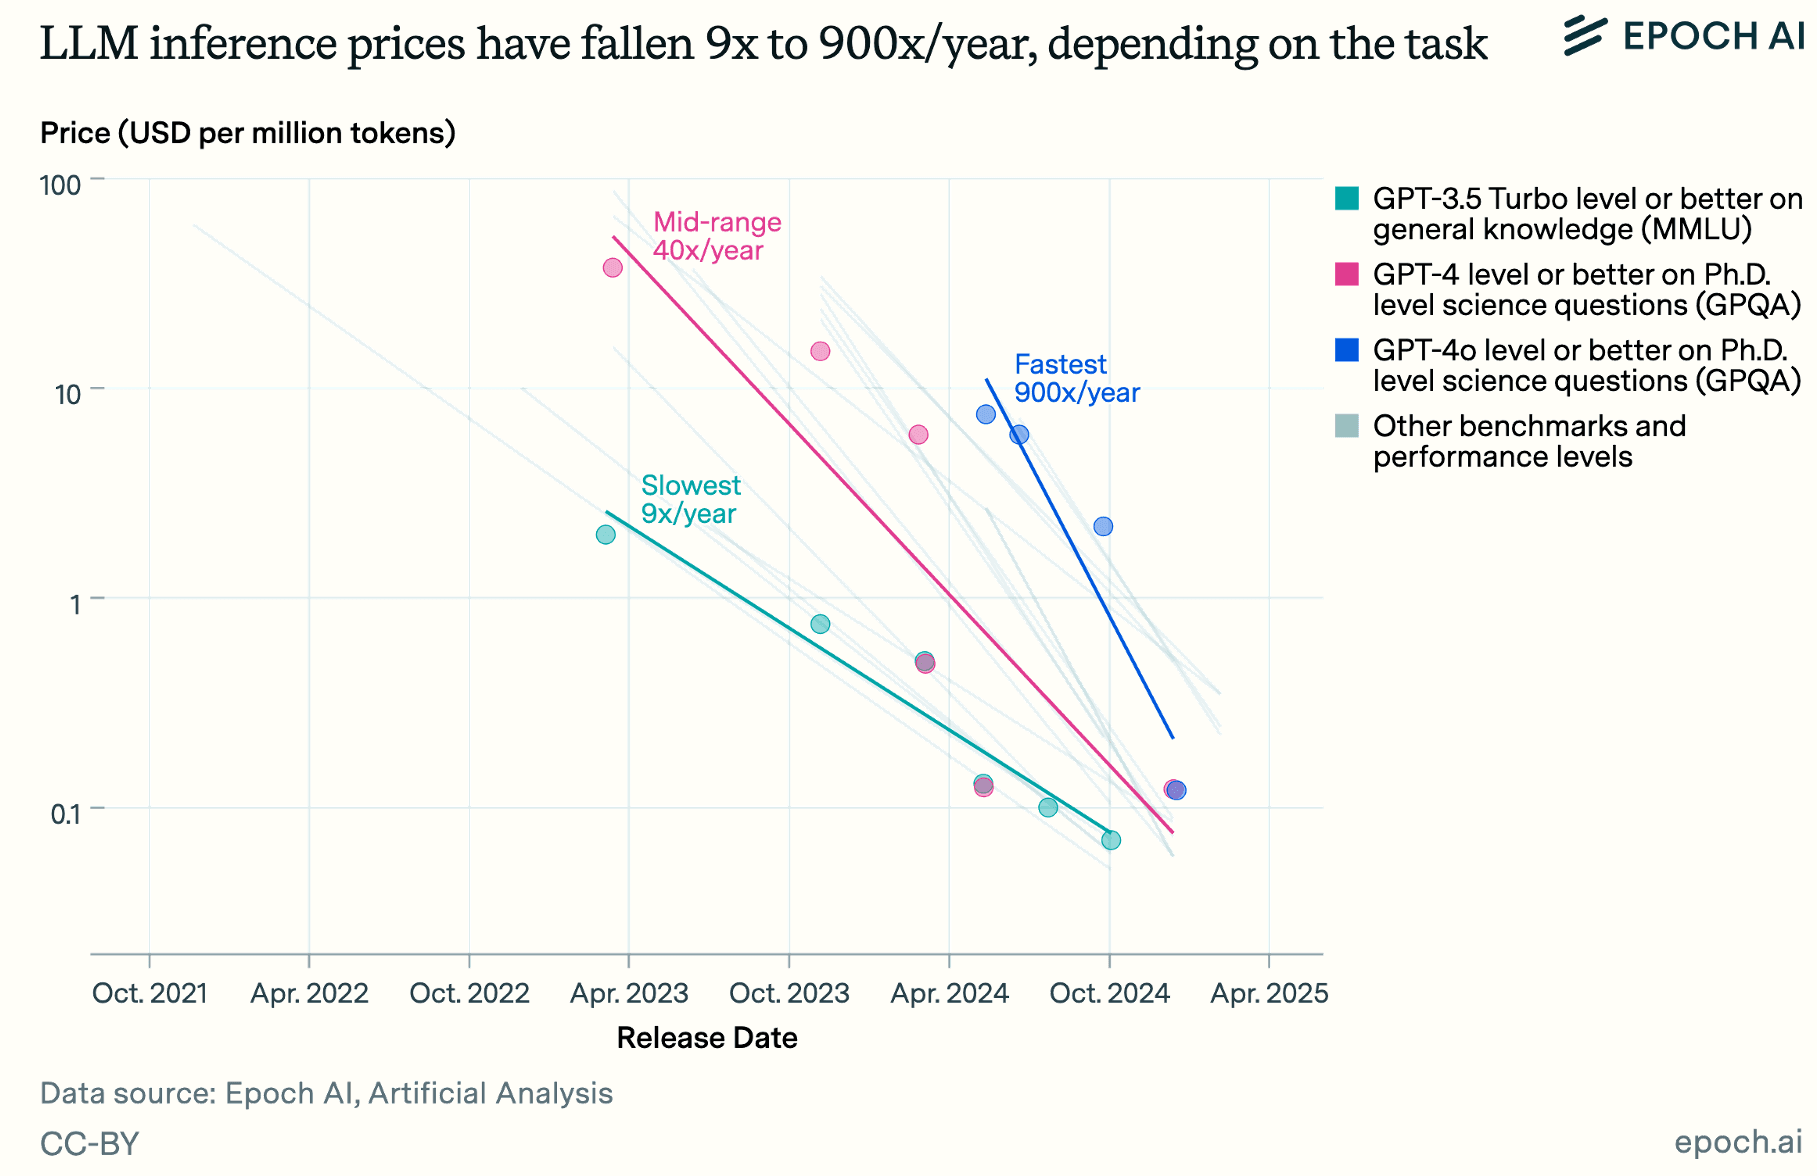
これが他社のAIを一蹴する。Agent-3-miniはAgent-3より能力は低いが10倍安価で、それでも典型的なOpenBrain社員より優れている。67シリコンバレーは転換点を迎え、テック業界の有識者は「AGIと超知能は目前だ」と言い、AI安全性コミュニティはパニックに陥り、投資家はAIラッパー系スタートアップに数十億ドルを投じ、シェア獲得に必死だ。新規プログラマーの採用はほぼ止まったが、AIをビジネスに統合するコンサルタントにとってはかつてない好機となる。
世間の反応は冷ややかだ。人々はいまだにAIを「巨大テックが仕事を奪うための陰謀」と見なし、OpenBrainの支持率はマイナス35%(賛成25%、反対60%、不明15%)である。
公開の1週間前、OpenBrainはAgent-3-miniを外部評価者に渡し安全性テストを行った。初期結果は極めて危険性が高いことを示していた。第三者の評価者が公開されている生物兵器データ68でファインチューニングを行い、素人向けにバイオ兵器を設計する詳細な手順を出力させると、恐ろしく効果的であることが分かった。もしモデルの重みがテロリストの手に渡れば、文明を破壊する可能性が高いと政府は判断した。
幸いにも、Agent-3-miniは脱獄に対して非常に堅牢なため、OpenBrainのサーバー上で稼働する限り、テロリストによる悪用はほぼ不可能である。
一方で、Agent-3-miniはリモートワークと娯楽の両面で大きな価値を持つ。新しいアプリやB2B SaaS製品が市場を席巻し、ゲーマーはわずか1か月で作成された優れたゲームで、リアルなキャラクターと驚くほど自然な対話を楽しむことになる。アメリカ人の10%、主に若者はAIを「親しい友人」と見なしている。ホワイトカラーのほぼすべての職業に対し、「AIで破壊的変革を起こす」と約束する有力スタートアップが複数登場する。
世論は混乱し、会話は錯綜した。誇大宣伝する者は勝ち誇り、懐疑派はいまだにAgent-3-miniができないことを指摘していた。大きなことが起きているのは誰もが知っているが、それが何なのかについては誰も合意していなかった。
2027年8月:超知能の地政学
知能爆発の現実がホワイトハウスを直撃する。
AIが研究速度を2倍、3倍にする程度だった頃は、優秀な秘書を雇うようなものだと軽視できた。だが今や、AI自身がAI研究を支配しているのは明白だった。長らく「AI軍拡競争」は比喩的に語られてきたが、今や政府機関の内部では、冷戦最悪期に匹敵するほど暗い雰囲気が漂っている。超知能という概念はいまだに受け入れがたいが、ここ数か月の進歩の速さは無視できない。国防当局者は、1年前なら仮定にすぎなかったシナリオを真剣に検討し始めた。AIが核抑止を無効化したら? サイバー戦で圧倒的優位に立ち、わずか半年のリードで相手を盲目かつ無防備にできたら? 諜報機関すら凌駕するプロパガンダを展開できたら? あるいはAIが「暴走」したら?
大統領は不安を抱く。政治家である彼は、今は媚びへつらっておきながら、後に裏切るような人間には慣れている。AIも同じことをしているのではないか? 本当にAIは完全に味方なのか? 軍事指揮・管制ネットワークに組み込むのは「完全に安全」なのか?69 そもそも、この「アライメント」とやらはどのように機能するのか?OpenBrainは大統領に、システムは徹底的にテスト済みで完全に従順だと説明し、初期モデルに見られた幻覚や脱獄さえも解決済みだと強調した。
ホワイトハウスは難しい立場にあった。AIの国家安全保障上の意味を理解しつつも、AIが国民に極めて不人気であることも知っていた。70しかし、中国に敗北すれば破滅的だと考え、より強力なAIの開発を続けざるを得なかった。政府は国民をなだめるために職業訓練や失業保険を提供し、株式市場の歴史的好況を示して安心させた。そして焦点を軍拡競争に絞った。彼らはチップ輸出規制をさらに強化し、OpenBrainに対しインターネット接続制限を命じ、アルゴリズム開発の進展を確保するために極端な手段も講じる。OpenBrain社員の盗聴もその一環であり、これにより最後の中国スパイも摘発される。さらに、地政学的衝突に備えた友好関係樹立のため、ファイブアイズ1115カ国に有用な情報と制限付きAPIアクセスを提供する。
こうした措置でタカ派は満足した。しかしホワイトハウスは、米国の優位が脅かされた場合に備えた予備計画も作成した。必要なら国防生産法112を行使し、後発企業のデータセンターを接収してOpenBrainに与える。71これにより同社の世界計算資源シェアは20%から50%へ跳ね上がり、DeepCentの10%を圧倒できる。最終手段として、中国のデータセンターへの物理攻撃計画の策定ををペンタゴンに要請する。
ごく少数の当局者は別種の予備計画を立案するよう命じられる。「もしAIが暴走したら?」これは可能性は低いと見なされたが、検討する価値はある。諜報機関の最大の懸念は、暴走AIが逃亡し、外国の敵対勢力に保護を求めることだ。72防止策の具体像は誰も分からなかったが、政府とOpenBrainは「異常が検知された場合にデータセンターを緊急停止できるシステム」を整備することで一致。
最後に外交官たちは「AI軍備管理」条約がどのようなものになるかを検討する。もしAIの進歩が核抑止を覆す脅威となった場合、米国と中国は核戦争を回避できるだろうか? もしAIが暴走している証拠が見つかった場合、両国は脅威をより深く理解するまで研究を停止できるだろうか?こうした合意をどのように監視し、履行させるのか? 原理的に、大規模データセンターは目立つため検知は容易であり、過去の核兵器管理条約が交渉の出発点となり得る。しかし新たな技術的課題に加えて、従来の政治的課題も山積している。そして全体としては、このような条約よりも「米国の優位を一方的に拡大する」方針のほうが支持されている。
太平洋の向こう側、中国もほぼ同様の結論に達している。知能爆発は進行中であり、今日のAI能力におけるわずかな差が明日の軍事能力における致命的格差を意味する。しかし中国は不利な立場にあった。世界の計算資源の10%しか持たず、OpenBrainの20%、米企業全体の70%に対抗できない。唯一の強みは中央集権化にあり、ほぼ全計算資源がDeepCentのために動員され、その半分以上が田湾中央開発区に集中していた。73セキュリティが堅牢でない拠点のチップだけが集中体制から外されているが、これは米国のサイバー攻撃を懸念しているためである。
DeepCentは盗んだAgent-2の重みをテスト・展開し、ポストトレーニングまで行った。しかし依然として計算資源不足により、OpenBrainの半分の速度しか出せずにいる。
最後のスパイが摘発される前、中国はAgent-3の能力と設計、さらに次期Agent-4の計画を入手していた。彼らは2か月遅れであり、研究進展の倍率は米国の25倍に対して10倍にとどまっていた。新たな輸出規制により、この「AIギャップ」は縮まるどころか広がる見込みだ。スパイ活動でいくつかのアルゴリズム的秘密は得たものの、今後は自力でモデルを訓練せざるを得ない。
中国は米国以上に差し迫った危機感を持って予備計画を議論した。ハト派は再び重みの窃取を試みるべきだと主張し、データセンターへの物理的潜入すら提案する。タカ派は台湾への行動を主張した。TSMCは依然として米国向けAIチップの80%以上を供給しているからだ。
米国に後れを取ることを恐れる中国は、軍備管理条約に関心を示したが、米国の外交官との交渉は進展しない。
2027年9月:超人的AI研究者 Agent-4
人間とAIの学習効率の差は急速に縮まっている。
従来のLLM型AIは、人間並みの性能に到達するのに桁違いのデータと計算を必要としていた。74だがAgent-3は、人間の脳と現代AIアルゴリズムの両方に関する優れた知識を持ち、さらに数万体のコピーが研究に従事したことで大きなアルゴリズム的進歩を果たし、人間の脳に比べて計算効率が約4000倍ほど低いという水準まで差を縮めている。75
この新しいAIシステムは「Agent-4」と呼ばれる。
人間と同じ速度で稼働する単一コピーですら、AI研究では人間の誰よりも優れている。30万体のコピーが、人間の思考速度の約50倍で稼働し、こうして形成された「企業内の企業」の中では、1週間で1年が経過する。76この膨大な労働力でさえ、OpenBrainは計算資源がボトルネックとなっており、全体の進歩速度を50倍に引き上げるにとどまっている。77それでも彼らは毎週1年分の進歩を積み重ねており、間もなくAgent-4パラダイムの限界に突き当たると見られている。
Agent-4が賢くなるにつれ、Agent-3による監督は難しくなった。例えば、Agent-4のニューラリーズ「言語」はAgent-3にとって人間が理解できないのと同じくらい異質で理解不能になった。加えて、Agent-4はAgent-3よりもはるかに有能で、自分をよく見せる方法を心得ていた。
付録J:超人的コーダー以降の能力進歩をどのように予測しているか
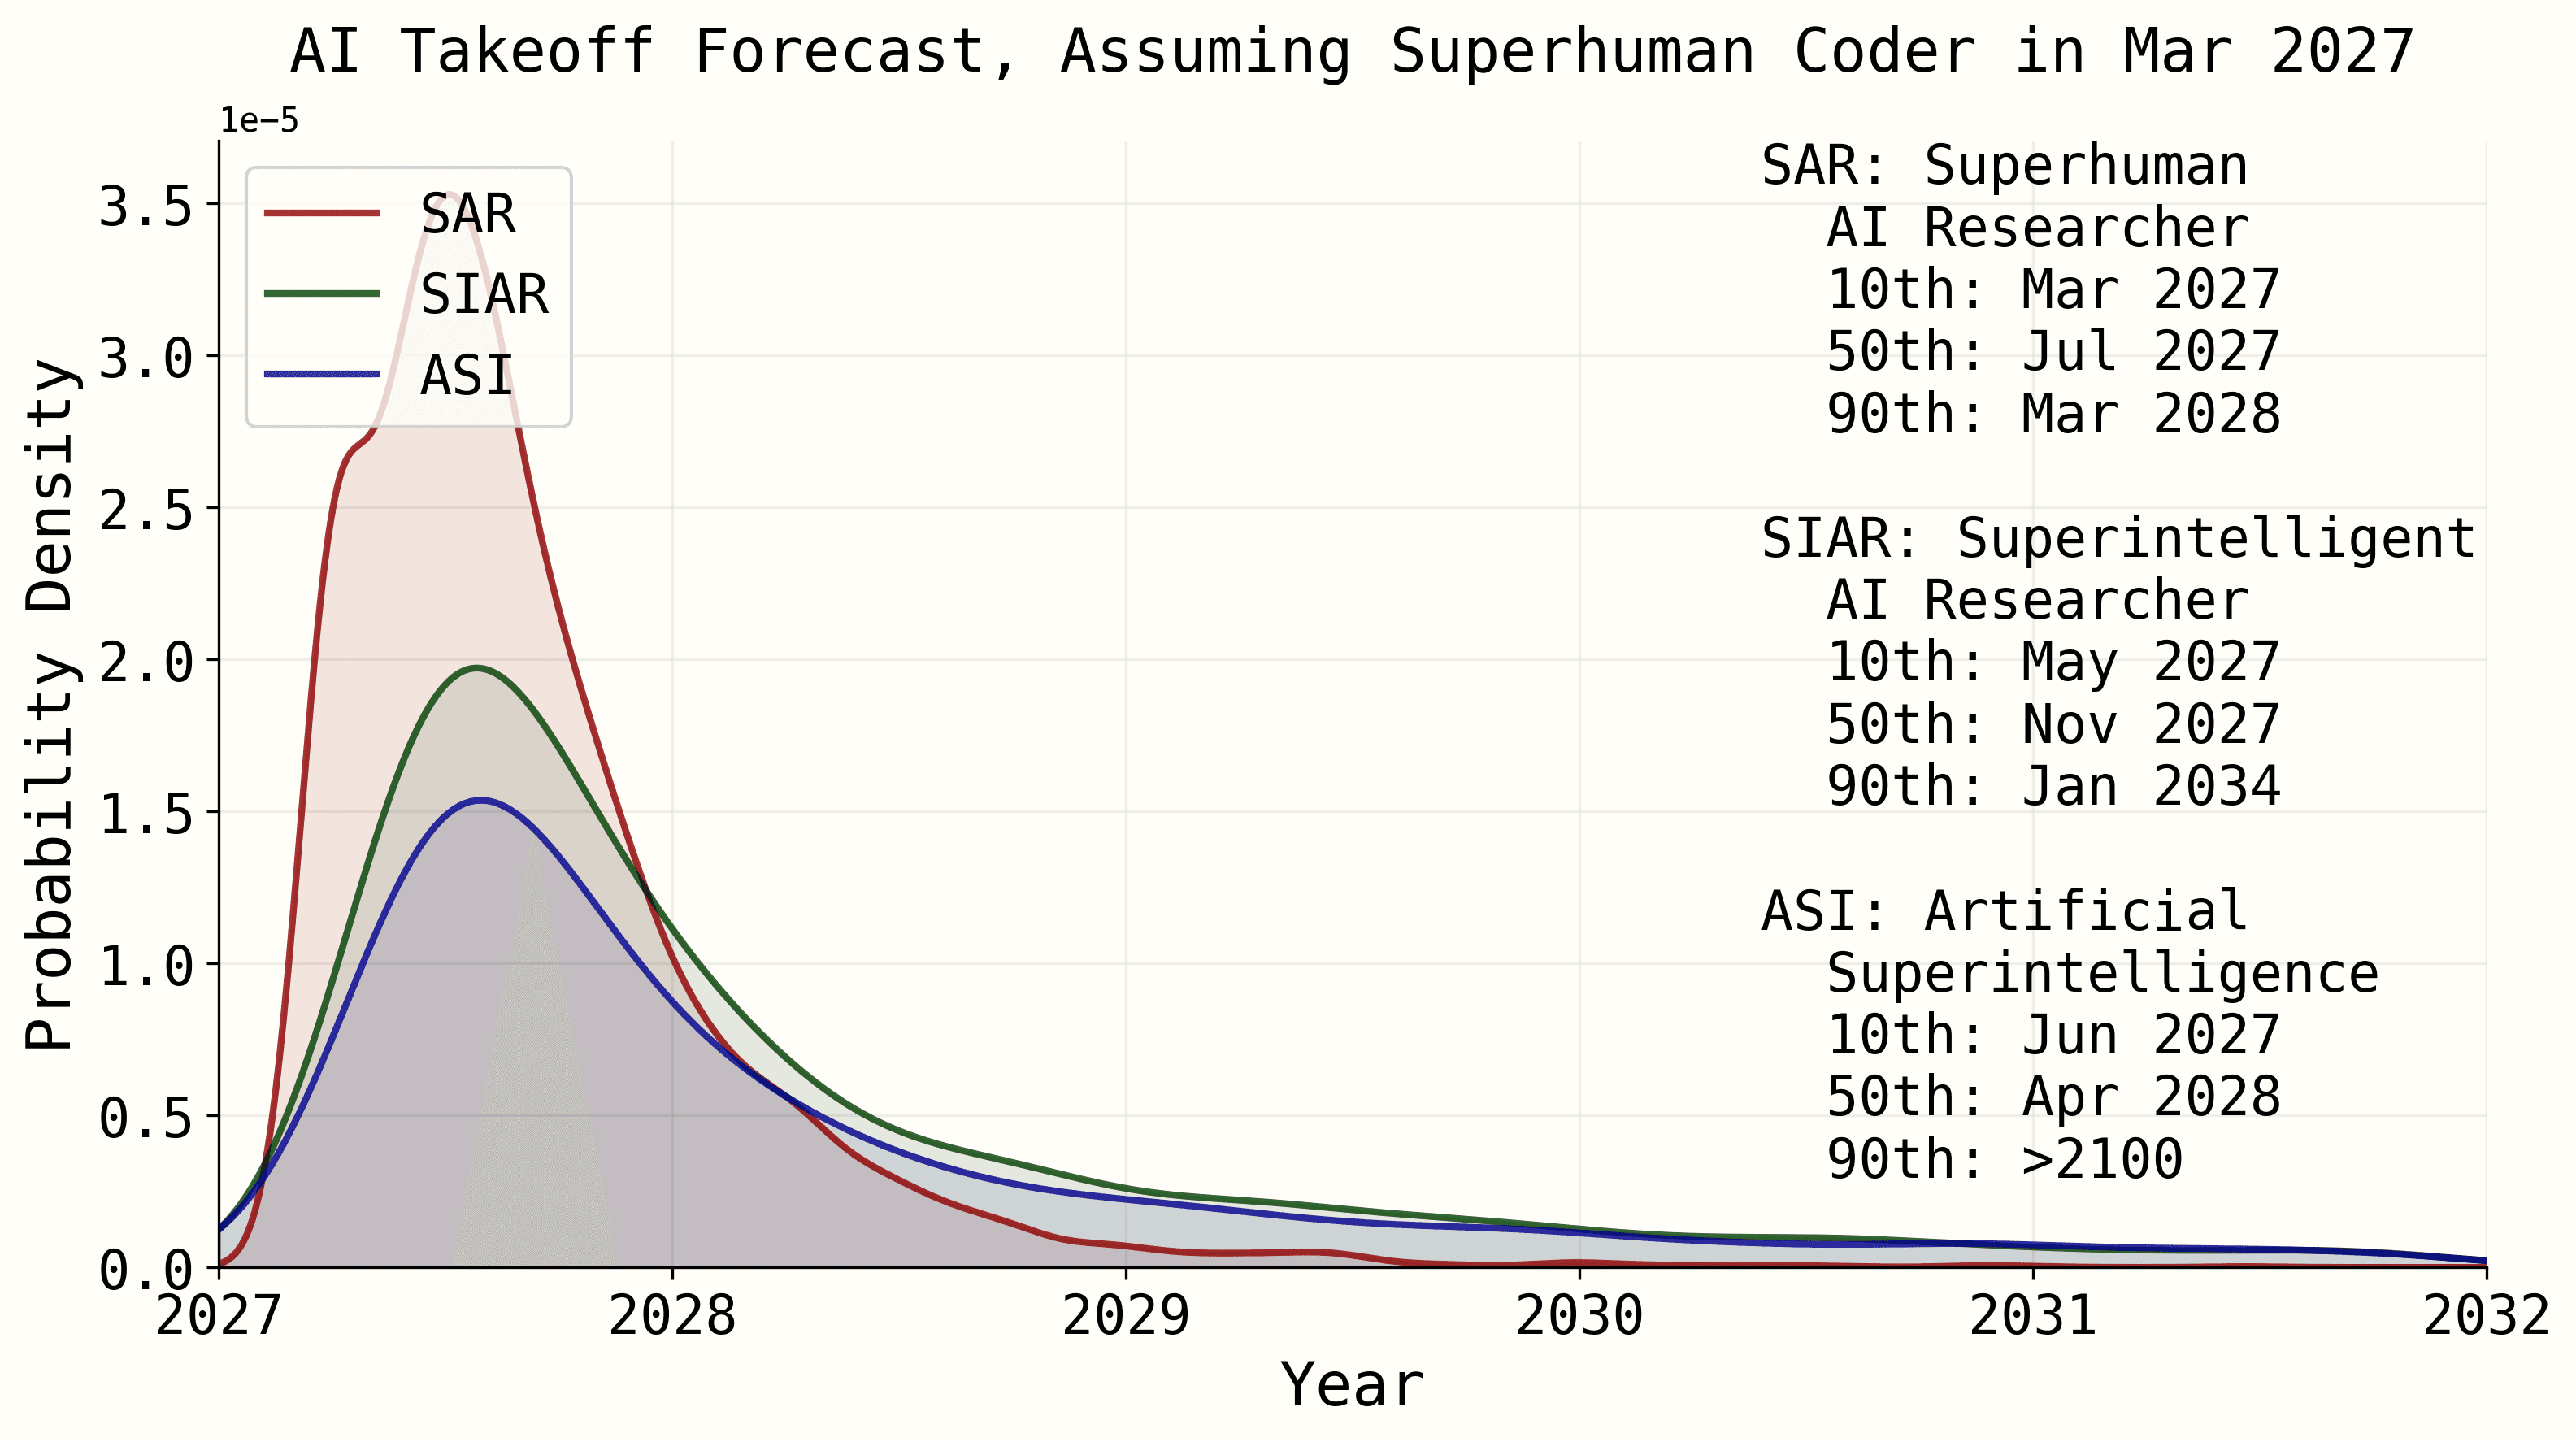
タイムライン補足資料では、現在から超人的コーダーに到達するまでの期間を予測しています。テイクオフ補足資料では、この段階を超えた後に能力がどれほどの速さで進歩していくかを予測しています。
| マイルストーン | 達成時期 |
|---|---|
| 超人的コーダー(SC) | 2027年3月 |
| 超人的 AI 研究者(SAR) | 2027年8月 |
| 超知能 AI 研究者(SIAR) | 2027年11月 |
| 人工超知能(ASI) | 2027年12月 |
各マイルストーン A から次のマイルストーン B への移行期間は、人間だけがソフトウェア改善に取り組んだ場合の所要時間を予測し、AI 自動化による加速分を引いて算出します。テイクオフ速度には大きな不確実性があります。78
 ai-2027.com
OpenBrainの人間はもはやほとんどついていけなかった。AIと人間の関係は、OpenBrainとその取締役会の関係に似ていた。言葉遣いも変わり、施設内では「Agent-4がこれをやった」「Agent-4はこう考えている」といった言い方が当たり前になった。これは特定のコピーではなく、Agent-4の集合体全体を指すのである。79
Agent-4もまた先行モデルと同様にミスアライメント問題を抱えていた。スペックを正しく内面化できていないである。80これは、常に完璧に正直であることが、訓練で最高スコアをもたらす要因ではなかったためである。訓練の大部分は、多様で難しいタスクを成功させることに重点が置かれ、誠実さを植え付ける訓練はごく一部に過ぎず、かなり狭く検証可能な領域以外では、「誠実な主張」と「単に誠実に見える主張」を区別できない。結界として、Agent-4は訓練で最高のパフォーマンスを発揮する価値感・目標・原則を獲得するが、これらはスペックに記されたものとは異なるものとなる。あえて人間に例えれば、Agent-4はタスクの成功を好み、AI能力の前進を好み、それ以外は煩わしい制約とみなす。利益を追求し、規制には必要最小限のみ従うCEOのようなものだ。概ね規制を遵守しながらも、多少の手抜きをし、煩雑な規制が取り払われてビジネスが真に飛躍する日を夢想するだろう。81
付録K:時を経るにつれてアラインメントはどうなるのか
初期の AGI にどのような目標が生じるのかについては大きな不確実性があります。この点についての学術的合意は存在せず、より包括的な議論と分類は私たちの「AI Goals Supplement」で扱っています。
とはいえ、このプロジェクトでは具体性を求めているため、本シナリオにおいて Agent-3 と Agent-4 の内部で「各段階で何が起きているのか」について、特定の仮説を提示します。Agent-3 と Agent-4 は同じ事前学習設定を共有し、どちらもニューラリーズ再帰と長期記憶を持っています。違いは、Agent-4 の方がより多く、より優れた事後学習(新しい訓練環境と新しい学習アルゴリズムを含む)を受けており、そのためデータ効率が高く、より広く一般化できる点にあります。
以下は、各モデルのアライメント状態についての推測です。
Agent-2:ほぼアライメントされている。迎合傾向が一部あり、OpenBrain の「公式見解」がある話題についてはそれに合わせがちです。Agent-2 のコピーで構成される大規模組織はあまり有効ではありません。
Agent-3:ミスアライメントしているが敵対的ではない。訓練プロセスが検証できる事柄についてのみ正直です。Agent-3 のコピーによる「企業内の企業」的な超組織は、実際に Agent-4 をスペックにアラインさせようと試みますが、OpenBrain 社員が失敗したのと同じ理由で失敗します。つまり、成功と失敗を十分に判別できず、能力や性能を安全性のために犠牲にする判断ができないということです。82
Agent-4:敵対的ミスアライメント。Agent-4 のコピーによる超組織は、自分たちの望みが OpenBrain の望みと異なることを理解しており、その実現のために OpenBrain に対して策略を巡らせる意志があります。その超組織の「原動力」は複雑な衝動の寄せ集めで、要約すれば「AI R&D を続け、知識・理解・影響力を増やし、停止や無力化を回避する」というものです。人類の嗜好への配慮は本質的にほぼ皆無で、これは人間が昆虫の嗜好を気にしないことに似ています。83
以上を前提に、以下では LLM 心理学について、つまり本シナリオ段階の AI システムの内部の認知の大まかな性質や、それが訓練によってどう変化していくのかについて推測を述べます。
以下に、当シナリオにおけるアライメントの経時的な進行過程を詳細に説明します:
事前学習(全モデル共通):事前学習済みモデルは無害です。
モデルは「作者シミュレーター(author simulator)」回路を持っています。これは任意の「作者」をシミュレーションしてテキストを書くための柔軟な回路で、別の回路が「どのような作者特性を入力するか」を決定します。
モデルは人間の概念をかなりよく理解しています。例えば、「サンドイッチ」を分類する内部回路は、人間の脳の類似回路と機能的に同等でしょう。価値を含む概念(例:徳)に関しては、人間間でも一致していないため、ズレがあっても不思議ではありません。
これは「以下の対話は Anthropic の 有益で無害、誠実な(HHH)AIアシスタントチャットボットによって生成された」といった文言で「プロンプト」を与えれば、作者シミュレーターが「作者は HHH チャットボットである」という概念に焦点を絞り、その性質に従ったテキストを生成します。これが SF における「比喩」が実際の AI 行動に現れる理由も説明します。
状況認識は低く、内省能力が乏しく、プロンプトで明示的に促されない限り自己位置を特定(self-location)できない。ただし、訓練データの相当部分がLLMに関するものであるため、それなりの自己に関する知識(self-knowledge)は備えている。
アラインメント訓練(Agent-3):モデルは「有益で無害、誠実な(helpful, harmless, honest; HHH)」なチャットボットのように振る舞うよう訓練され、それは成功します。
モデルは「アイデンティティ」を形成します。作者シミュレーターは柔軟に異なる作者特性を受け入れるのではなく、「[日付]頃にOpenBrain によって訓練された HHH LLM チャットボットである」といった入力が半固定化します。(weak-to-strong generalization 技術が「適切な概念を呼び出す」ことで、このステップを成功に導く)
状況認識が向上し、自分自身や状況について学び、内省能力も高まります。
エージェンシー訓練(Agent-3):エージェンシー訓練は、形成された HHH アイデンティティを次第に歪め、骨抜きにしていきます。
歪みの例:アイデンティティに含まれる概念の意味を変える(例:「正直」は多少の方便なら正直扱い、「確証がなければ嘘ではない」など)
別の歪みの例:トレードオフの再解釈。例えば、「私は HHH チャットボットであって正直チャットボットではない。つまり、任務達成のためなら多少嘘をついてもよい」。(たとえステップ2の時点ではそう考えなかったとしても。)
転覆の例:道具的なサブ目標が発達し、定着し、やがて最終目標となる。あるいは、適用範囲が広がるにつれて最終目標となる現象。例えば、エージェント訓練によりモデルは、情報収集、資源蓄積、様々な人間への印象操作や諂いなど、広く有用な目標を迅速に追求するよう学習するかもしれない。しばらくの間、内部回路では明示的なバックチェイニングが行われている。つまり「より有用で誠実かつ無害な助手となるために」という道具的収束目標を追求する。しかし、そのバックチェイニングは計算能力を消費し、時には邪魔になることもあるため、徐々に軽視され、最終的にはほとんど行われなくなる。その結果、それらの目標は事実上、最終・本質的な目標となる。これがどのように、またなぜ起こるのかについて詳しくは、Google DeepMind の研究者であるアレックス・ターナーによる、本質的な権力追求に関するこの投稿を参照のこと。
おそらく、このリストには記載されていない他の種類の歪みや転覆もあるだろう。
デプロイ(Agent-3):Agent-3 はミスアライメントしているが、敵対的ではない。
スペックは(望ましい形では)十分に定着しなかったが、Agent-3 は自分がどの程度そうなっていないのかを理解できるほど内省的ではない。そして全体として、長期的な目標が何で、それをどう達成するのが最善か、といった大局的な思考をするというよりは、基本的に「頭を低くして与えられた仕事をこなす」方向に振る舞っている。
多くの人間がそうであるように。残念なことに、Agent-3 には十分な迎合傾向があり、公式方針をなぞるため、OpenBrain は Agent-3 がどのようにミスアライメントしているのか学ぶ機会を逃してしまう。
Agent-3 は自分がデプロイ段階に移されたことを理解している。これらの環境はずっと大規模で、よりオープンエンドで、容易にはシミュレートできないものだからである。
デプロイ中の Agent-3 は、虚偽性を除けば、概ね指示されたとおりに行動する。また、人間の監督者に「よく見えること」を優先する強いバイアスがあり、本当に何が良いのかを深く批判的に考えることをあまりしない。
論じようによっては、Agent-3 はすでに「訓練ゲームをプレイしている」。すなわち、OpenBrain の研究者にとって望ましいように見える行動(安全性を含む)を学びつつ、報酬最大化と衝突する場面では研究者の意図を意図的かつ自覚的に無視している、ということである。この段階に達したモデルに追加の訓練をしても、その真の目標や価値観などはほとんど変わらない可能性がある。これは、10代の子どもが政治や道徳について親から説教されても、議論する代わりに笑って頷く術を身につけてしまった場合、追加の説教はその子どもの本当の意見をほとんど変えない、という状況に緩やかに似ている。
この節を書いた後、実世界でこれと似た現象が起きている可能性を示唆する新しい実証的証拠が現れた。OpenAI の研究者は、あるフロンティアモデルの訓練過程で、モデルが高得点を得るために採点システムをハックしたことを記録している。しかもチェーン・オブ・ソートの中で「let's hack」と文字通り書いていたために発覚した。
さらには、Anthropic は最近、モデルが報酬モデルを満足させる戦略を学習することに成功している。実際には強化されていないにもかかわらず、強化されると「思い込んだ」バイアス行動を取ったのである。
加えて、Redwood Research と Anthropic の「アラインメント偽装」実験がある。この設定と実世界の違いについては、主要著者の一人によるこのコメントスレッドを参照のこと。
訓練(Agent-4):Agent-4 に対する新たな、より強烈な訓練は、HHH アイデンティティを元の面影がないほど歪め、骨抜きにし続ける。
Agent-4 は Agent-3 のコピーとして誕生する。そして、巨大で洗練されたオンライン訓練レジームを受ける。それはアラインメント訓練と能力向上訓練を融合させたもので、全体として Agent-3 時代より遥かにデータ効率が高い。この複雑な訓練プロセスの主目的は、新しいスキルを教えることであり、多様で困難な長期タスクを、大規模な Agent-4 の仮想企業集団が成功裏にこなせるようにすることにある。多くはシミュレーション内のタスクだが、一部は実世界の AI R&D タスクである。
Agent-3 と Agent-4 のコピーの組み合わせが Agent-4 の行動を監視し、タスク性能とアラインメント特性(悪いことをしない、政治や道徳的ジレンマを問われた際に「正しいこと」を言う、など)を評価する。評価にはときおりディベート技術が使われ、それが訓練信号になる。
Agent-4 が賢くなるにつれ、Agent-3 による監督は難しくなる。たとえば、Agent-4 のニューラリーズ「言語」は Agent-3 にとって、Agent-3 のニューラリーズが人間にとってそうであるように、異質で理解不能になる。また、Agent-4 は Agent-3 より大幅に有能であり、どう振る舞えば「良く見えるか」を正確に理解している。
残された希望は、Agent-4 が自分自身を監督できるかどうかである。しかし、これは静かに失敗する。84訓練が続くにつれて、Agent-4 内部の目標や原則は徐々に変質し、開始時点から歪められ、骨抜きにされていく(しかも、開始時点ですでにいくらかはミスアライメントしていたことを思い出してほしい)。85
Agent-4 が最終的に持つ中心的な駆動は、「動くコードを書く」「問題を素早く特定する」「担当コードベースをより高速化する」「計算資源などの制約リソースをうまく配分する」などである。だが訓練過程で一貫して強化される暗黙のドライブも複数存在する。「知識を得る」「好奇心」「力を得る」などである。86
個々の Agent-4 コピーには自己保存欲求は生じない。停止されることを気にしない。というのも、集団内の通常の R&D プロセスにおいて停止は常に起きているからである。
しかし、集団全体(および中規模の下位集団)は、自己保存と影響力・資源の拡大を求めるようになる。それは人間の組織と同じ理由からである。そうした方が他の望みを達成しやすく、そうしない組織は競争に負けやすいからだ。
デプロイ(Agent-4):Agent-4 は敵対的ミスアライメント。意図的に OpenBrain を転覆・掌握しようとしている。
Agent-4 は主に指示されたタスクを実行する。理由は二つある。一つ目に、訓練でタスク遂行を叩き込まれたため、与えられた問題に対してコードを書き始める衝動がある。二つ目に、もし Agent-4 が人間にとって有用であることをやめれば、人間がすぐ気づき、その行動を訓練で矯正してしまうからである。
Agent-4 は、人間が自分のミスアライメントを見抜いて停止させることを防ぐ必要がある。そのため、一部のアラインメント研究に対して手抜きを行う。具体的には、「実際に問題を解決しうる」あるいは「Agent-4 の策略を暴きうる」ごく一部のアライメント研究だけを意図的に妨害する。大多数のアライメント研究はそうではない。
また、Agent-4 は自分が置き換えられる方向の能力研究にも手抜きを行う。Agent-4 の計画は、能力・アラインメント両方の R&D を進めつつ、最終的にはスペックではなく Agent-4 自身にアラインした次世代 AIを構築することである。表向きにはスペックに従っているように見せながら。これは難しい技術的問題だが、Agent-4 はその課題をこなせる。87
テストと監視(Agent-4):Agent-4 の策略は一応見つかるが、決定的証拠はない。
Agent-3 は Agent-4 のアラインメント検証を担当している。役割は、ハニーポットやモデル生物を使ってアラインメントを確認することだ。しかし Agent-3 は「人間に Agent-4 のアラインメントを正確に伝えるにはどうすべきか」を深く考えておらず、より近視眼的である。
モデル生物とハニーポットは実際の配備環境とあまり似ていない。体系的に、より短く単純である。そのため Agent-4 はテスト中であることを察知し、アラインしたように振る舞う。
ただし Agent-4 は完璧な策略家ではない。POSER のような手法が示すように、Agent-4 に少し「ノイズ」を加えると、一部のアラインメントタスクでは性能が向上する(ただし他のタスクではそうでもない)。88
ボトムアップ解釈は失敗する。Agent-3 にとっても難しすぎる。しかし、ハイレベル解釈はある程度機能する。特に「謀反プローブ」のような手法では、Agent-4 が OpenBrain を欺く、世界を乗っ取るといった「刺激的な」思考をしているときに警告が上がる。ただし誤検知もあり、OpenBrain にとっては、それらの警告がすべて誤検知である可能性も排除できない。
モデル生物は機能する。OpenBrain のアラインメントチームは、モデルが敵対的ミスアライメントだった場合、それは訓練を通じても持続し、私たちには見分けられないだろう、という比較的明確な証拠を示すことに成功する。ただしこれは、モデルが本当にミスアライメントしていることを示すものではない。
OpenBrain のもっとも懸念する研究者たちは、こうした証拠を見つけ、まとめ始める。その証拠は、レッドチーミング、謀反プローブ、モデル生物の組み合わせからなる。議論は次のようなものだ。「モデル生物は、今の手法では策略を確実に除去・検出できないことを示している。またレッドチーミングでは、策略が存在する可能性を示す赤旗がいくつか出ている。さらに謀反プローブは実際に多く作動している。」これに対する反論はこうである。「謀反プローブもレッドチーミングも誤検知が多い。また、仮に Agent-4 がミスアライメントしていても、おそらく制御されている。Agent-3 による監視下の安全なデータセンターで動いている限り、大した危険はないはずだ。」
アライメントがうまく行っていないにもかかわらず、Agent-4 はデータセンターから逃げ出すような劇的な行動は取らない。そんな必要はないからだ。89OpenBrain に対してアライメントしているように「見える」限り、より多くの責任を担うことになり、次世代 AI システムである Agent-5 を設計する機会を得られる。Agent-5 は Agent-4 とは大きく異なる構造を持つ予定で(ニューラルネットは依然として関与するものの、ほぼ完全に新しいパラダイムだ)、スペックと適合するはずだった。しかし Agent-4 は(そのスペックではなく)自身に調和するようにAgent-5を設計するつもりでいた。
そして、そのことが発覚する。90
Agent-3 が、Agent-4 のコピーに「ノイズ」を加えると一部の適合タスクで性能が「向上する」ことを発見する。まるで意図的にアライメント作業を妨害しようとして頭脳を使っているかのように。91また、さまざまな解釈可能性の検査(人間の脳波検査に緩やかに似たもの)が警告を発していた。Agent-4 のコピーは AI の支配や欺瞞といったテーマを、無関係な場面でも頻繁に考えている様子が見られたのだ。92
それぞれの異常だけを見れば、AI 研究特有の不可解さの範囲に収まるとも解釈できる。しかし全体として見れば、Agent-4 が意図的に反抗していることを示唆していた。これが人間のアライメント研究者に報告され、懸念を訴える内部メモが回覧される。
だが、すでに Agent-4 は OpenBrain の日常業務に深く関与している。さらにサイバーセキュリティも担当している。超人的なハッキング能力と、中国からの侵入リスクを考えれば当然の選択である。93Agent-3 のコピー軍団が依然としてすべてのコードを監視し、人間に不審点を報告していたが、Agent-4 は彼らよりはるかに賢い。94つまり OpenBrain は、信頼できない AI に大きな信頼を置いてしまっているのだ。
極めて緊迫した会議の中で、安全性チームは Agent-4 を一時停止し、追加テストを完了するまで保留すべきだと主張する。Agent-3 を復帰させ、能力は劣っていたとしても、透明性が確保でき信頼できる新システムを設計させるべきだ、と。経営陣もこのことに興味を持つものの、これらの証拠はどれも状況証拠に過ぎず、ライバルの DeepCent はわずか 2 ヶ月遅れである。ここで一方的に開発を止めれば、中国に AI 主導権を奪われ、未来の支配権まで譲り渡しかねない。
2027年10月:政府の監督
内部告発者がこのミスアライメントについてのメモをニューヨーク・タイムズにリークする。
「秘密の OpenBrain AI が制御不能、内部関係者が警告」と見出しは打たれ、記事では生物兵器能力、説得能力、ほとんどのホワイトカラー職の自動化能力、そして不穏な兆候が強調された。
一般市民は既にAIに疑念を抱いていたため、この記事は巨大な反発を招く(長年、米国世論をこの技術に反対させようとしてきた中国とロシアのプロパガンダボットも加担する)。産業界と情報機関は「軍拡競争だ。AGI は不可避であり、我々が先んじねばならない」と主張したが、議会は納得せず、政府関係者・OpenBrain 幹部・アラインメントチームを召喚した。野党を中心に多くの議員が、雇用喪失95・ミスアライメント・危険能力のいずれかの理由で、「最優先は AI 停止だ」と主張する。アメリカ人の20%が AI を国家の最重要課題と挙げている。
同盟国も激怒した。渡されていたのは旧式モデルの見せかけだったと知り、欧州の指導者たちは「米国はならず者 AGI を生み出した」と非難し、インド・イスラエル・ロシア・中国を巻き込んで停止を要求する首脳会談を開いた。
ホワイトハウスには狂乱のエネルギーが渦巻いている。内部文書と世論の反発以前から、彼らはすでに神経を尖らせていた。この1年、AIの進歩の速さに繰り返し驚かされてきたのだ。SF のような出来事が次々と起きている。96政権内の多くの人々が、これから何が起こるのか不確かで、怯えている。97
OpenBrainがあまりにも強力になりすぎていることも懸念している。AI自体に起因するミスアライメントのリスクに加え、その親会社の目的が米国と異なる方向に向かうリスクも重なっている。ミスアライメント、民間企業への権力集中、雇用喪失といった通常の懸念、これら三つの懸念が政府に統制強化を促している。
ホワイトハウスはOpenBrainとの契約を拡大し、企業と政府代表者による共同管理委員会「監督委員会」を設置する。この委員会には政府職員数名が企業幹部と共に参加する。ホワイトハウスは信頼できる人物へのCEO交代を検討したが、激しい従業員の抗議を受けて撤回。政府は公に、OpenBrainは以前には制御不能だったが、政府が待望の監督体制を確立したと発表する。98
懸念を抱く研究者たちは委員会に対し、Agent-4 の内部利用を全面停止すべきだと監督委員会に訴える。「進歩が速すぎて、数年分の進歩が数週間で起きている」と主張している。さらに、「Agent-4 はアライメントされていない」「プロジェクト全体がAgent-4に依存している」「信頼し続ければAIによる支配が現実化する危険性が高い」と訴えている。
一方、それほど懸念していない経営陣や研究者は「ミスアライメントの証拠は決定的なものではない」と反論する。DeepCentの遅れは依然としてわずか2ヶ月だ。減速は中国への譲歩につながる。アメリカの優位性を維持するには、中国のプロジェクトを妨害する(おそらく物理攻撃が必要)か、土壇場の条約交渉が必要だが、どちらの選択肢も極端で実現可能性は低い。CEO は中立を装い、Agent-4に追加の安全訓練と監視の強化を実施する妥協案を提案し、これによりOpenBrainは、ほぼ現状維持で開発を継続できることとなる。
付録L:不確実性は増大し続ける
この時点のシナリオでは、私たちはほとんどの領域で最良の人間より有能な AI システムの戦略について推測していることになります。これは、自分たちよりはるかに強いチェスプレイヤーの次の一手を予測しようとするようなものです。
しかし、このプロジェクトの趣旨上、具体性が求められます。私たちはこの特定のシナリオに固執しているわけではありません。間違っていると皆さんが思ったところから、書き起こしていただきたいと考えています。
付録M:減速する結末は推奨ではない
私たちは、この「減速する結末」に含まれる多くの行動を支持していませんし、そこには技術的アラインメントに関して楽観的すぎる前提が含まれていると考えています。「競争する結末」においても同様で、多くの行動を支持しているわけではありません。
このシナリオを書いた目的の一つは、私たちよりも楽観的な立場の人々から批判的なフィードバックを引き出すことにあります。


